跳到主要内容

瑞兴生物RXBio

多组学技术服务与深度数据挖掘 · 从研究设计到实验验证的全流程支持
Oxford Nanopore · 三代测序

直接 RNA 测序 ONT-DRS

其他 RNA 测序测的都是 RNA 的"拷贝"——先逆转录成 DNA,再扩增。拷贝做出来了,RNA 分子本身的化学修饰也就跟着丢了。ONT-DRS 不复制:把天然 RNA 链直接牵过纳米孔测序,修饰照原样保留在电流信号里,poly(A) 尾的长度也是实测值。代价是要的 RNA 多得多。

  • 不逆转录不 PCR
  • 保留 RNA 碱基修饰
  • m6A / m5C / Ψ
  • poly(A) 尾长
  • 全长 isoform
天然RNA直接测 RNA 分子本身,不经拷贝
≥50µg RNA起送量高,是常规全长路线的 25 倍
修饰直读m6A、m1A、m5C、m7G、hm5C、Ψ
细胞≥2×10⁸以细胞送样时的起送量
01

技术简介

RNA 上有一层独立于序列的信息:RNA 修饰。目前已知的主要修饰包括 m6A、m6Am、m1A、m5C、ac4C、m7G、Ψ(假尿苷)和 A-to-I 编辑。它们由特定的酶添加、去除、识别和编辑,影响 RNA 的生成、转运、功能和代谢——序列没变,但分子的命运变了。

要看到这一层,二代测序得靠多种技术分别去做:m6A 用抗体富集(MeRIP-seq / m6A-seq),Ψ 用化学转化,poly(A) 位点用 PAS-seq,尾长用 PolyA-seq 或 PAL-seq。每种技术看一种修饰,看全就得全做一遍,而且每换一种方法就要换一批样本、换一套建库。

Oxford Nanopore 的 DRS(Direct RNA Sequencing)把这件事合成一步:直接测序天然 RNA 链,不合成第二链 cDNA,也不做 PCR 扩增。因为测的就是原始分子,碱基上的化学修饰会改变穿孔时的电流信号,仪器能从信号里把修饰读出来;同时避免了逆转录和扩增环节引入的错误,poly(A) 尾长度也能直接测准。

02

技术优势

完善基因注释

发现新的转录本和基因,获得全面的转录组图谱。

三个层面的差异分析

差异表达基因(DEG)、差异表达转录本(DET)、差异使用转录本(DTU)。

基因结构分析

准确分析可变剪接(AS)、多聚腺苷酸化位点(APA)、3′UTR 长度与 poly(A) 尾长。

RNA 修饰分析

m6A、m1A、m5C、m7G、hm5C、Ψ 等修饰可从电流信号中识别。这是 DRS 相对 cDNA 路线的独有能力——修饰信息在逆转录时会被抹掉,只有直接测 RNA 才拿得到。

转录本分辨率

在转录本水平解析调控机制。修饰位点是挂在具体 isoform 上的:同一个基因的两条 isoform 可以有不同的修饰状态,只有全长读段能区分。

03

技术原理

纳米孔测序读的是电流:一根蛋白孔嵌在膜上,两侧加电压形成恒定电流;单链核酸在分子马达的牵引下以固定速度穿过纳米孔时,孔内的碱基会引起特征性电流变化,仪器按电流轨迹判读序列。

关键在于测的是哪条链。cDNA 路线测的是逆转录产物,是 RNA 的拷贝;DRS 把 RNA 分子本身牵过纳米孔。碱基上的化学修饰(比如 m6A 的那个甲基)会改变该位置的电流特征,因此不需要抗体、不需要化学处理,修饰信息直接留在原始信号里,靠碱基识别算法还原。

代价是通量和样本量。RNA 分子比 DNA 更"娇气",没有 PCR 这一步做信号放大,一条 RNA 只能测一次,所以要得到足够深度的数据,起始 RNA 量必须大——这也是 DRS 要求 ≥50 µg 而 cDNA 路线只要 ≥2 µg 的原因。

04

实验流程

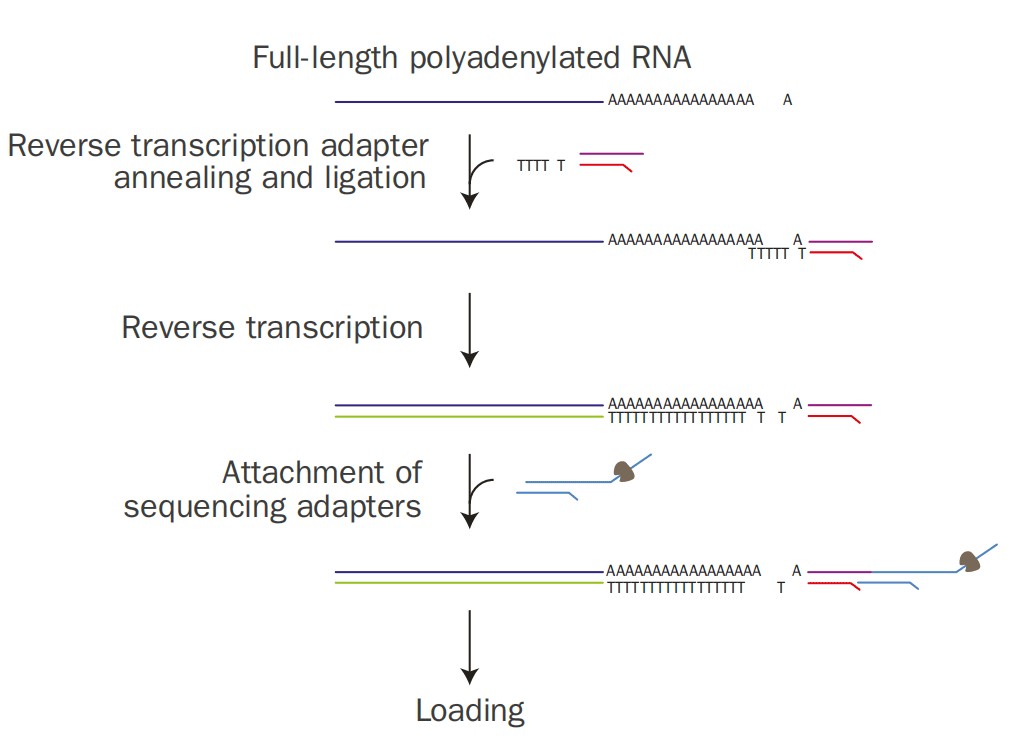
1

引物退火连接

带有 oligo(dT) 末端的引物与 mRNA 的 poly(A) 尾巴退火并连接

2

反转录成杂合链

反转录形成 RNA–DNA 杂合链(这一步是为了稳住分子、提供马达结合位点,不是测序对象)

3

连接测序接头

添加连有分子马达的测序接头

4

上机测序

马达牵引 RNA 链穿过纳米孔,直接读取天然 RNA 序列与修饰信号

ONT 直接 RNA 测序建库流程:oligo dT 引物与 poly A 尾退火连接、反转录形成 RNA-DNA 杂合链、连接带分子马达的测序接头
DRS 建库:oligo(dT) 退火 → 反转录成杂合链 → 连接马达接头 → 直接测 RNA
05

送样要求

DRS 的送样门槛明显高于 cDNA 路线,请在项目设计阶段就确认能凑够量,不要等取样后才发现不够。

样本类型ONT-DRS说明
RNA 总量注意≥50 µg是 lrRNA-seq / PAlrRNA-seq(≥2 µg)的 25 倍,无 PCR 放大所以必须靠起始量堆深度
RNA 纯度OD260/280 ≥1.8DRS 建库酶反应更敏感,纯度不达标会直接影响得率
RNA 完整性RIN ≥7.0特殊物种如没有 28S 条带,以 Agilent 2100 基线平整为准
细胞≥2×10⁸ 个TRIzol 充分裂解后 −80 ℃ 保存,干冰运输
动物组织 · 心、脑、肾、肺≥300 mg新鲜组织块尽量 ≤0.5 cm;去除结缔组织与脂肪;预冷 1×PBS 或生理盐水洗去血迹,液氮速冻 1 h 后 −80 ℃ 保存,干冰运输。DRS 所需组织量约为常规路线的 5 倍,请提前规划取材
动物组织 · 肝、脾、胃≥100 mg
动物组织 · 皮肤、血管、软骨、骨等坚韧组织≥500 mg
植物组织≥2000 mg选健康幼嫩组织,液氮速冻 20 min 以上,干冰运输
全血 / 免疫细胞不建议血量或细胞量难以达到起送门槛,建议改用组织或培养细胞
凑不够 50 µg 怎么办:先别放弃,两条路可选。一是减少目标——如果只关心某几个基因或某条通路的修饰状态,可以走靶向路线(ONT-TlrRNA-seq 的 RNA 版本)把测序量集中在目标区域;二是重新评估科学问题,如果课题的核心不是修饰、只是 isoform 和剪接结构,改用 PAlrRNA-seq(≥2 µg)同样能拿到全长和尾长,只有修饰这一项拿不到。具体怎么取舍,建议把样本情况和课题目标一起发给技术顾问评估。
06

分析内容

标准分析 STANDARD

  1. 全长 reads 识别与质控全长序列判定、比对到参考转录组 / 基因组
  2. isoform 鉴定与定量已知 / 新转录本分类、表达量矩阵
  3. 差异表达分析DEG / DET / DTU 三个层面
  4. poly(A) 尾长测定逐条 read 的尾长估计与样本级分布
  5. 可变剪接与 APA七类 AS 事件、APA 位点、3′UTR 长度

高级分析 ADVANCED

  1. RNA 修饰位点鉴定m6A、m1A、m5C、m7G、hm5C、Ψ 等修饰的位点与修饰比例估计
  2. 修饰差异分析组间修饰水平比较、差异修饰位点与差异修饰基因
  3. 修饰与表达 / 稳定性的关联修饰水平与 mRNA 丰度、尾长的联合分析
  4. 修饰位点序列特征motif 分析、修饰位点在转录本上的位置分布
  5. isoform 特异修饰同一基因不同 isoform 的修饰状态差异
07

应用案例

案例一
IF 16.6 Molecular Cell · mRNA Nm 修饰

2′-O-methylation at internal sites on mRNA promotes mRNA stability

mRNA 内部位点的 2′-O-甲基化修饰促进 mRNA 稳定性

期刊:Molecular Cell(IF 16.6) · 发表时间:2024 年 6 月
研究团队:哈佛大学医学院 / 波士顿儿童医院陈开富课题组与西北大学曹圻课题组
阅读原文:doi.org/10.1016/j.molcel.2024.04.011
Nm 修饰的 mRNA 稳定性分析:FBL 结合与 Nm 修饰对 mRNA 稳定性的影响
Nm 修饰的 mRNA 更稳定,FBL 结合的 mRNA 稳定性同样增强

研究背景:稳定的 mRNA 对 RNA 疫苗和 RNA 治疗很关键。Nm 修饰(2′-O-甲基化)长期被认为主要存在于 rRNA 等非编码 RNA 上,近年发现 mRNA 内部也有大量位点,但这些位点的功能和碱基分辨率的化学计量一直不清楚。
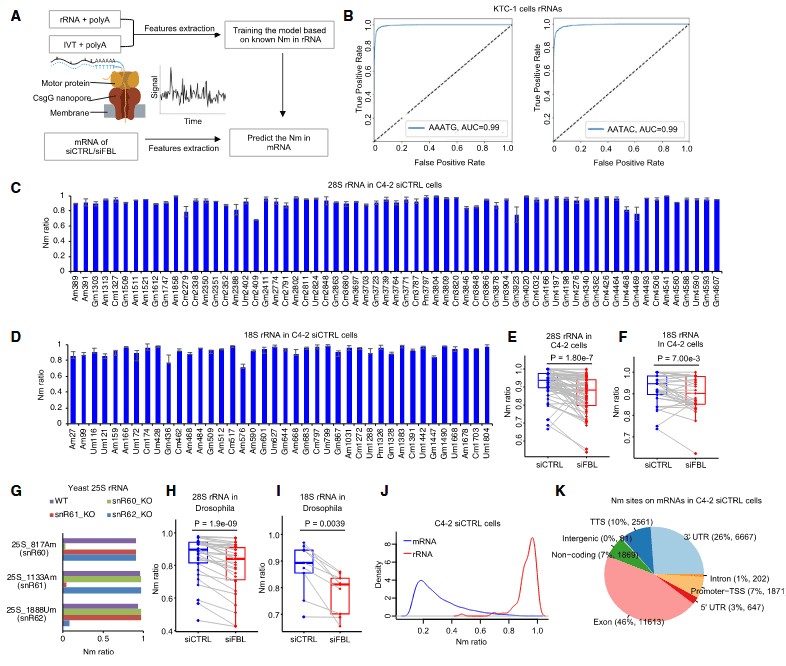
NanoNm 方法:结合纳米孔测序与机器学习识别 Nm 修饰位点
NanoNm:纳米孔测序 + 机器学习,单碱基分辨率识别 Nm 位点

方法与分析:作者把纳米孔测序和自己开发的机器学习方法 NanoNm 结合起来,以单碱基分辨率在 mRNA 上识别了数千个 Nm 位点。该方法在人、酵母和果蝇的核糖体 RNA 样本上验证过。实验显示:Nm 修饰的 mRNA 比未修饰的更稳定;FBL 蛋白结合的 mRNA 稳定性同样增强;敲低 FBL 后,Nm 修饰的 mRNA 稳定性和表达水平都显著下降。在前列腺癌中,FBL 表达升高与肿瘤相关通路 mRNA 的 2′-O-甲基化水平升高相伴;关键驱动基因 PSMD13 的 mRNA 上检出 Nm 修饰,并与其更高稳定性相关。
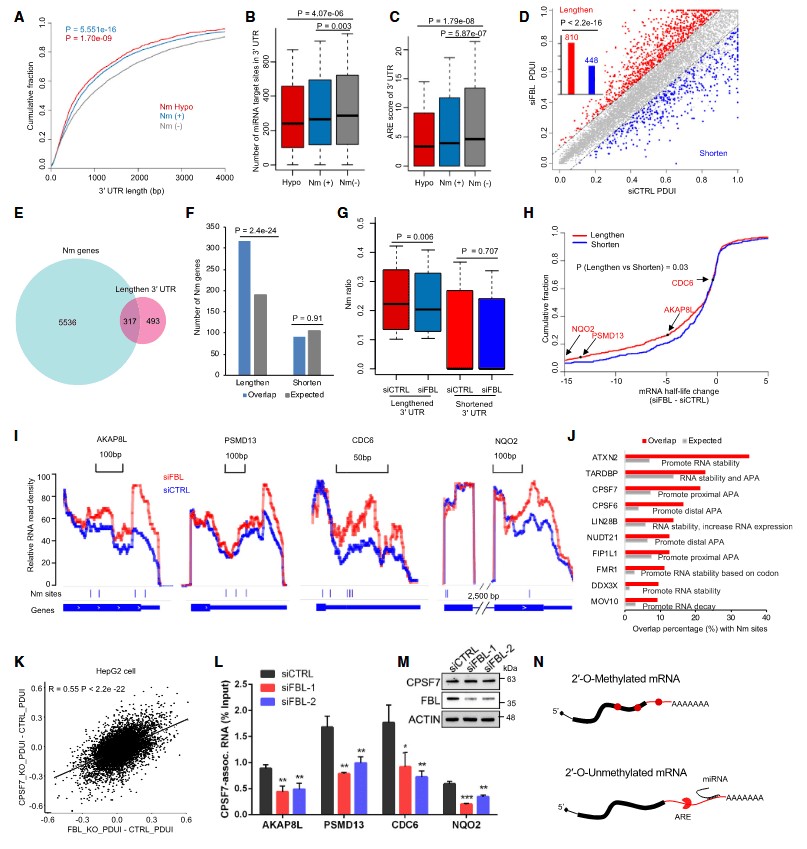
FBL 介导的 Nm 修饰与 3 UTR 缩短及 APA 调控的关系分析
Nm 位点与 RNA 结合蛋白结合位点高度重叠,指向 APA 调控

机制发现:带 Nm 修饰的基因倾向于拥有更短的 3′UTR,而敲低 FBL 会明显改变 3′UTR 长度——提示 FBL 介导的 Nm 修饰可能通过调节 3′UTR 长度来增强 mRNA 稳定性。结合 CLIPdb 公共数据分析发现,ATX2、CPSF7 等 RNA 结合蛋白的结合位点与 Nm 修饰位点高度重叠;同时敲除 FBL 与 CPSF7 时,APA 模式的变化与单独敲除 FBL 一致,说明 CPSF7 确实能识别 Nm 修饰并参与稳定性调控。

08

常见问题

DRS 和 MeRIP-seq(m6A 抗体富集)应该怎么选?
看你要什么粒度。MeRIP-seq 给的是"区域":抗体富集后测序,分辨率在 100–200 nt 左右,知道修饰落在这一段里,但不知道具体哪个碱基,也没有化学计量(修饰比例)。DRS 给的是"位点":单碱基分辨率,能估计修饰比例,而且一次实验同时覆盖 m6A、m1A、m5C、m7G、Ψ 等多种修饰,不用为每种修饰各做一套建库。代价是 DRS 需要 ≥50 µg RNA,样本门槛高得多。
为什么 DRS 要 50 µg 而别的只要 2 µg?
因为没有 PCR 这一步。cDNA 路线会把每个分子扩增出很多拷贝,测序深度靠扩增堆出来;DRS 测的是天然 RNA 分子本身,一条分子只能过孔一次、测一次。想拿到足够的 reads 量,只能靠加大起始 RNA 量。这不是优化能绕过去的,是原理决定的。
修饰分析的准确性怎么把控?
修饰是靠电流信号差异判定的,需要对照。常规做法有三层:一是用已知修饰状态的标准品(体外转录的修饰 / 未修饰 RNA)校准模型;二是用敲除或敲低修饰酶的样本做负对照,比如敲低 METTL3 看 m6A 信号是否消失;三是对关键位点用正交方法(如 SELECT、GLORI 等)验证。建议项目设计时就规划好对照组,这一点比测序深度更影响结论的可靠性。
修饰能和 isoform 对应起来吗?
能,这是 DRS 相对短读长修饰检测的一个明显优势。因为一条 read 覆盖全长转录本,读到的修饰位点天然带着 isoform 归属信息,可以比较同一个基因不同 isoform 之间的修饰差异。反过来,只做 gene 水平的修饰统计会把这个层面的信息抹掉。
poly(A) 尾长也测得到?和 PAlrRNA-seq 比怎么样?
测得到,而且 DRS 测的是天然 RNA 上的尾巴,没有逆转录和扩增环节,原理上更接近真实状态。PAlrRNA-seq 的优势是样本门槛低(≥2 µg vs ≥50 µg)并且带 UMI 可做绝对定量。所以:样本量充足且同时要修饰 → DRS;样本有限、只关心尾长和 isoform → PAlrRNA-seq。
RNA 降解一点还能做 DRS 吗?
不建议。DRS 没有扩增补偿,降解 RNA 直接表现为长 reads 比例下降、有效数据量不足,比 cDNA 路线更容易失败。RIN 低于 7.0 的样本建议重新取样;如果是特殊物种没有 28S 条带,以 Agilent 2100 基线平整为准,可先小量试建库评估。
项目周期多久?
样本与 RNA 质检合格后,建库测序约 4-6 周,标准分析约 2 周。修饰位点鉴定、差异修饰分析等高级分析按需求另行约定;如果需要设计修饰酶敲除等对照组实验,周期另计。
Get A Solution

获得技术方案

您有任何关于组学测序的项目问题,请留言给我们。技术团队将在工作日 24 小时内给您答复。

项目咨询

技术顾问对接具体课题,先讨论科学问题再谈检测清单

027-87050299

sales@rxbio.cc

寄样收样

李欣 13237124769
武汉市东湖高新区高新二路 388 号光谷生物医药加速器 18 栋 1-2 层

提交您的项目需求

填写以下信息,我们会尽快与您联系并给出技术方案建议。

提交即表示同意我们通过电话或邮件与您联系,仅用于项目沟通。