01
技术简介
DNA 甲基化 是 DNA 甲基转移酶(DNMT)把甲基加到胞嘧啶上、形成 5-甲基胞嘧啶(5-mC)的表观遗传修饰,通常会抑制基因转录。CpG 位点(序列上相邻的一个 C 和一个 G)在基因组里不是均匀分布的,而是密集聚集在被称为 CpG 岛(CGI) 的区域;脊椎动物大多数基因的启动子就落在这些 CpG 岛里。启动子区域的甲基化状态变化,和基因表达以及肿瘤等疾病状态直接相关——比较肿瘤与正常样本之间的甲基化差异,是找调控机制的一条常用路径。
测甲基化位置,传统上靠亚硫酸氢盐测序(BS-seq ):用化学处理把未甲基化的 C 转成 U,甲基化的 C 保持不变,测序后比对出差异。问题在于 BS-seq 需要很大的数据量才能覆盖全基因组,而成本更低的简化方案 RRBS (用限制性内切酶切出富 CpG 片段)只能覆盖基因组约 1–5% 的 CpG 位点 。
纳米孔测序可以直接检测胞嘧啶的甲基化状态 ,不需要亚硫酸氢盐转化——甲基会改变碱基穿孔时的电流信号,仪器从信号里读出来。剩下的问题是怎么把测序能力集中到 CpG 密集的区域。RRMS 用的办法是自适应采样(Adaptive Sampling, AS) :在测序过程中优先丢弃非目标区域的分子,从而提升目标区域(如 CpG 岛)的覆盖度。
按 RRMS 方案,测序针对人类基因组中富含 CpG 的 310 Mb 区域(小鼠为 308 Mb),内容包括所有已注释的 CpG 岛、shores、shelves 以及超过 90% 的启动子区域(含有 4 个以上 CpG 的启动子则 100% 覆盖),此外还包含基因组中其他富 CpG 的区域。配套的 bed 文件共记录 718 万个 CpG 位点 。
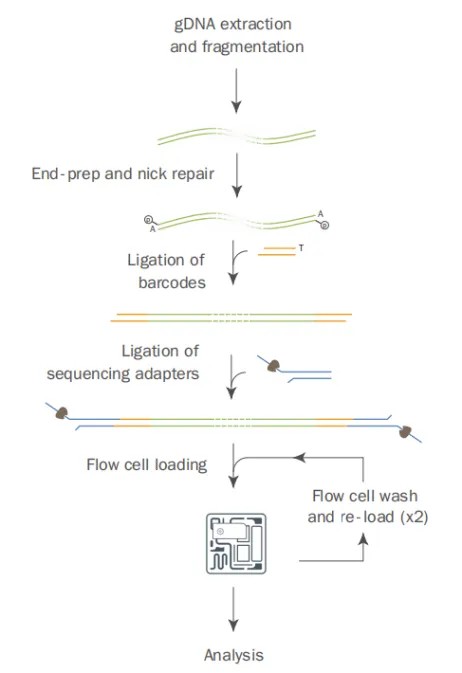
ONT-RRMS:片段化 → 末端修复 → 连接接头 → 自适应采样测序
02
技术优势
简单方便
不需要化学试剂转化,也不需要做限制性内切酶处理 。少了亚硫酸氢盐这步,DNA 不会被化学处理打断降解,对样本量的压力小很多,实验环节也少。
覆盖度高
人靶向测序区域 310 M ,小鼠靶向测序区域 308 M 。相比 RRBS 只覆盖 1–5% 的 CpG 位点,这个覆盖面把 CpG 岛之外的 shores、shelves 和大部分启动子都装进来了。
多种甲基化修饰
5mC、5hmC、6mA、4mC 等一次测出。亚硫酸氢盐路线有一个已知短板:5mC 和 5hmC 在化学处理后区分不开;纳米孔按电流信号区分,两类能分开。
变异分析
可以同时分析 CNV、SV 和 SNP 。同一批数据既出甲基化又出变异,不用为结构变异单独建库——这是长读长相对短读长甲基化方案的一个实际好处。
单碱基分辨率
可以在单碱基水平检测甲基化状态,并支持表观单倍型(allele-specific methylation)分析——同一条 read 上的甲基化状态连着看,能区分来自父本还是母本等位基因。
03
技术原理
自适应采样是纳米孔平台特有的功能,靠软件控制实现富集。流程是这样的:DNA 分子在马达牵引下开始穿孔,仪器先读它最初几百个碱基 ,把这几百个碱基与预先设定的靶向区域(本方案就是那份 718 万个 CpG 位点的 bed 文件)做比对。
比对结果是二选一:这个分子落在目标区域 ,就让它完整通过、正常测序;不在目标区域 ,软件立刻反转纳米孔两端的电压,把这条分子从孔里弹出去 ,孔位随即空出来给下一个分子。
好处很直接:不用在实验台上做捕获或富集,省掉一整轮探针杂交和洗脱操作;同一张芯片的测序能力被集中用在你关心的区域上,等效覆盖深度明显提高。想换目标区域,改 bed 文件重新上机就行,不用重做样本。
04
实验流程
1 提取基因组 DNA 提取高质量 gDNA,总量需达到送样门槛
2 片段化 对 DNA 进行片段化,打断后平均长度约 6 kb
5 RRMS 自适应采样测序 ONT 测序仪运行自适应采样程序,加载 bed 文件锁定富 CpG 区域(人 310 Mb / 小鼠 308 Mb,含 718 万个 CpG 位点),实时「留 / 弹」目标分子
两个关键设计:① 片段平均长度控制在 6 kb 左右,是为了同时兼顾两件事——够长,才能跨过重复区域、支撑 SV 与单倍型分析;够短,才能在自适应采样判读最初几百个碱基时快速给出「留 / 弹」的决定,减少孔位浪费。② bed 文件圈定的是人和小鼠基因组的富 CpG 区域,测序时非目标区域的分子会被实时丢弃,孔位集中在甲基化信息最密集的区段上。
05
送样要求
DNA 的完整性是这类项目的关键 ——长片段比例不够,自适应采样的效率和后续 SV 分析都会受影响。
样本类型 ONT-RRMS 说明
DNA 总量 ≥10 µg 高于常规 gDNA 测序(≥5 µg),因为自适应采样会主动丢弃一部分分子 DNA 纯度 OD260/280 1.7–1.9 ;OD260/230 2.0–2.2 230 比值偏低通常提示有胍盐、酚或糖类残留 DNA 完整性核心 琼脂糖凝胶电泳 5 kb 以下无小片段 ;片段大小检测仪器(Qseq / Agilent 2100)在 5 kb 以下无明显峰 这一步不合格的样本最常见,建议送样前先自检 细胞 ≥2×10⁷ 个 由我方提取 gDNA 更稳妥 动物组织 · 心、脑、肾、肺 ≥100 mg 取新鲜组织,块尽量 ≤0.5 cm;去除结缔组织与脂肪;预冷 1×PBS 或生理盐水洗去血迹,液氮速冻后 −80 ℃ 保存,干冰运输,避免反复冻融 动物组织 · 肝、脾、胃 ≥40 mg 动物组织 · 皮肤、血管、软骨、骨等坚韧组织 ≥200 mg 植物组织 ≥2000 mg 植物多糖多酚会干扰 DNA 提取,取样量需加大 全血 4 mL 按血液样本常规采血管要求采集与运输 免疫细胞 干体积 ≥20 µL 一般 10 µL 细胞干体积对应约 1×10⁶ 个细胞
最常见的送样失败原因: DNA 提取时机械打断过度,或者反复冻融导致片段变短。这类样本电泳看主带还在,但 5 kb 以下已经有一片拖尾,上机后自适应采样命中率低、SV 检不出。建议提取时轻柔操作、避免剧烈涡旋,宽口枪头吹打而非反复吸打;分装保存,一次取用一管。完整版要求以最新版《送样规范》为准。
06
分析内容
标准分析 STANDARD
数据质控与靶向区域统计reads 质控、靶向区域富集倍数、目标区域覆盖深度
甲基化位点检测5mC / 5hmC / 6mA / 4mC 的单碱基甲基化状态判定
甲基化水平统计CpG 位点甲基化比例、基因与启动子区域甲基化水平
差异甲基化分析组间差异甲基化位点(DMS)与差异甲基化区域(DMR)
区域注释与富集DMR 落在启动子 / CGI / shores / shelves 的分布与功能富集
高级分析 ADVANCED
表观单倍型分析同一条 read 上的甲基化状态连读,区分等位基因来源
等位基因特异性甲基化印记区域与等位基因差异甲基化识别
变异检测联合同一批数据出 CNV、SV、SNP,与甲基化结果交叉
甲基化与表达关联启动子甲基化水平与对应基因表达量的关联分析
肿瘤 vs 配对正常比较配对样本的 DMR 筛选与候选基因优先级排序
07
应用案例
案例一
IF 15.7
Nature Communications · DeepMod2
A signal processing and deep learning framework for methylation detection using Oxford Nanopore sequencing
基于牛津纳米孔测序的甲基化检测信号处理与深度学习框架
期刊: Nature Communications(IF 15.7) · 发表时间: 2024 年研究团队: 美国宾夕法尼亚大学阅读原文: doi.org/10.1038/s41467-024-45778-y
DeepMod2:从纳米孔电流信号直接检测 DNA 甲基化
研究发现: 作者开发了 DeepMod2 ,一个用纳米孔测序离子电流信号检测 DNA 甲基化的深度学习框架。它能在 CPU 上高效运行,可以推断表观单倍型,也可以直接做甲基化判定。与闭源工具 Guppy 和 Dorado 相比,性能相当,且是开源的。
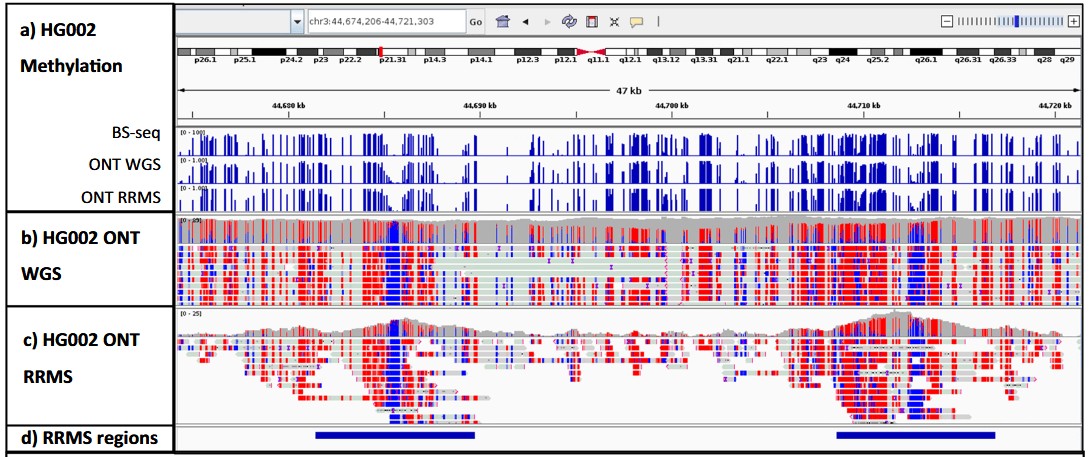
IGV 图:RRMS 在靶区内的 CpG 检出量显著高于全基因组测序
数据表现: 图中展示了全基因组与 RRMS 两条路线的 reads 和甲基化调用,并比较了 RRMS 的 reads 覆盖。用 DeepMod2 在 HG002 的 RRMS 数据中检测 5mC:CpG 基序内的胞嘧啶,全基因组范围内检出 39 个,靶区内检出 1,399 个 ;汇总到 CpG 位点层面,全基因组 248 个,靶区 717 个 。RRMS 区域内检出的聚合 CpG 数量也明显多于靶区外的 CpG。
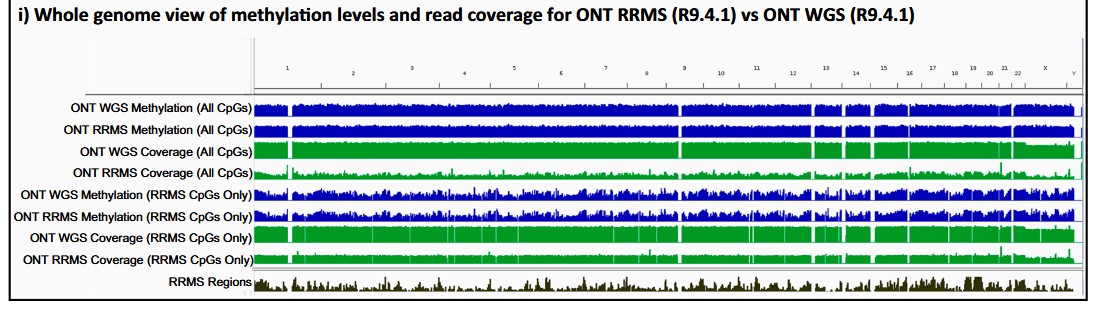
RRMS 轨迹与覆盖峰重合,靶区相对靶外区域明显富集
覆盖度验证: 图中展示了 ONT RRMS 与 WGS 数据集的覆盖范围和甲基化水平,以及 RRMS CpG 与全部 CpG 的轨迹、RRMS 靶区轨迹。可以看到 RRMS 轨迹和覆盖峰重合,靶区相对靶外区域存在明显富集 ——这正是自适应采样在测序端做选择的效果。
08
常见问题
和 WGBS、RRBS 相比,RRMS 的定位是什么? 三条路线各有取舍。WGBS 覆盖最全 ,但要把整个基因组测到足够深度,数据量与成本都高,而且亚硫酸氢盐处理会降解 DNA。RRBS 最便宜 ,靠限制性内切酶切出富 CpG 片段,但只覆盖约 1–5% 的 CpG 位点,CpG 岛之外基本看不到。RRMS 折中 :靶向 310 Mb 的富 CpG 区域(含全部 CGI、shores、shelves 和 90% 以上启动子),不做化学转化,同时还能出 CNV、SV、SNP。
不做亚硫酸氢盐转化,甲基化结果可靠吗? 原理不同,各有验证方式。亚硫酸氢盐靠化学反应区分甲基化与未甲基化;纳米孔靠甲基引起的电流信号差异 判定。可靠性通常用三层来保证:用已知甲基化状态的标准品(如 HG002 这类有公认甲基化图谱的参考样本)校准;与 WGBS 或芯片结果做交叉比对;用修饰酶敲除样本做负对照。案例里的 DeepMod2 就是在 HG002 上做的性能比对。
5mC 和 5hmC 能分开吗? 能,这是纳米孔路线相对亚硫酸氢盐的一个实际优势。常规 BS-seq 里 5mC 和 5hmC 在化学处理后表现一致,要分开得额外做氧化亚硫酸氢盐测序(oxBS-seq)。纳米孔按电流信号区分,两类可在同一次实验中分别判定。
靶向区域能自己定吗? 能。默认用富 CpG 的 310 Mb(人)/ 308 Mb(小鼠)区域,包含全部注释的 CpG 岛、shores、shelves 和 90% 以上启动子。如果你的课题聚焦特定基因集、印记区域或某个染色体区段,可以换成自定义 bed 文件上机——换 bed 不用重做样本 ,这是自适应采样相对实验端捕获的一个便利之处。请提前把目标区域发给技术顾问评估大小和可行性。
为什么强调 5 kb 以下不能有片段? 两方面的原因。一是自适应采样靠长 reads 提效 :片段太短,一条 read 测完也进不了几个目标 CpG,孔位利用率下降。二是SV 与单倍型分析需要长片段 :短片段跨不过重复区域和结构变异断点,表观单倍型也连不起来。所以送样规范里把"5 kb 以下无小片段"单列为核心指标。
需要几个生物学重复? 做差异甲基化分析建议每组至少 3 个生物学重复;肿瘤 vs 癌旁这类配对设计可以用配对样本做统计,重复数要求会低一些,但仍建议不少于 3 对。
项目周期多久? 样本与 DNA 质检合格后,建库测序约 4-5 周,标准分析约 2 周;表观单倍型、等位基因特异性甲基化、甲基化与表达关联等高级分析按需求另行约定。