跳到主要内容

瑞兴生物RXBio

多组学技术服务与深度数据挖掘 · 从研究设计到实验验证的全流程支持
功能基因组 · 表达调控

转录组测序 RNA-seq

mRNA 是由 DNA 一条链为模板转录而来、携带遗传信息并指导蛋白质合成的一类单链 RNA。RNA-seq 用 oligo(dT) 富集带 poly(A) 尾的 mRNA 建库,结合高通量测序回答最基础的问题:哪些基因在表达、表达量变了多少、剪接方式有没有变。这是绝大多数组学项目的第一步。

  • oligo(dT) 富集链特异文库
  • 差异表达基因
  • 可变剪接分析
  • 自研 SUVA 剪接流程
  • 进口 / 国产多平台
RNA≥1 µg自提样需浓度 ≥100 ng/µL、RIN ≥7
多平台可选进口 / 国产测序平台,自有分析流程
4类核心分析定量 / 差异表达 / 可变剪接 / 功能富集
全物种覆盖动物、植物、真菌、血液与体液均可
01

技术简介

mRNA 测序使用 oligo(dT) 富集建库方法结合高通量测序,研究 mRNA 的表达和调控,广泛应用于各类基础研究。它的定位很明确:把样本里带 poly(A) 尾的成熟 mRNA 抓出来测序,用 reads 数推断每个基因的表达量,再比较不同样本、不同处理之间的差异。

在这个基础之上,还有几类扩展建库方式,用于回答不同问题:

全转录组测序

不同于只能获取 mRNA 信息的转录组测序,全转录组测序通过两种不同的建库方式,可以同时对 pre-mRNA、lncRNA、circRNA 或 miRNA 进行测序并单独分析;还可进行多种 RNA 联合分析以及内源竞争性 RNA 整合分析、分子标记筛选等,探究潜在的调控网络机制,全面揭示转录调控问题。

rRNA 剔除建库
pre-mRNA-seq / lncRNA-seq / circRNA-seq

rRNA 是细胞中含量最多的一类 RNA,测序时大量 rRNA 会掩盖其他基因的测序丰度,因此需要去除 rRNA 来构建链特异文库,从而获得 lncRNA、mRNA、circRNA 数据。

小 RNA 建库
miRNA-seq

miRNA 相较于其他三类 RNA(pre-mRNA、lncRNA、circRNA),序列较短,只有 18–26 nt,所以构建文库的方法不一样,需要分别上机测序。

02

技术优势

进口 / 国产多测序平台

Illumina、华大、真迈多个测序平台可选,按项目预算与数据量要求灵活配置,数据质量稳定可追溯。

自有分析流程

从质控、比对到定量与差异分析全流程自主搭建,参数透明、结果可复现,不依赖第三方脚本拼装。

自研 SUVA 剪接分析

可变剪接已纳入标准分析。自主开发的 SUVA 流程按剪接位点使用变异定义 alt3p、alt5p、olp、contain、ir 五类事件,以 pSAR 与剪接比例差异筛选组间差异剪接事件,已在多个项目文章中作为核心数据支撑。

数据高级分析

WGCNA、GSEA 与 GSVA、生存分析、变异位点检测等高级模块可按需叠加,支撑从筛选到机制阐释的完整链条。

个性化服务支持

针对非模式物种、特殊样本类型与定制化分析需求提供专项方案,实验设计与分析策略一并讨论。

03

实验流程

1

总 RNA 提取

TRIzol 或柱式法提取总 RNA,同步去除基因组 DNA

2

RNA 质检

Nanodrop 测纯度、Qubit 定量、Agilent 2100 测 RIN,不合格当场反馈

3

mRNA 富集 / rRNA 剔除

oligo(dT) 磁珠抓带 poly(A) 尾的 mRNA;要看 lncRNA、circRNA 则改用 rRNA 剔除

4

片段化与逆转录

镁离子加高温把 RNA 打断成短片段,随机引物逆转录合成一链 cDNA

5

二链合成与末端修复

DNA 聚合酶 I 与 RNase H 合成二链并掺入 dUTP,随后补平末端

6

加 A 尾与接头连接

3′ 端加 A 后连接双端 index 接头,AMPure XP 磁珠做片段分选

7

UDG 处理与 PCR 扩增

UDG 酶消化带 U 的二链保留链方向信息,PCR 富集得到链特异文库

8

文库质检

Qubit 定量结合 Agilent 2100 检测插入片段分布,主峰约 300 bp

9

上机测序

Illumina 平台双端测序(PE150),按数据量要求配置样本上机通道

第 5、7 步是链特异性文库的关键。二链合成时掺入 dUTP,再用 UDG 酶把这条链消化掉,最后测序读到的 reads 就只来自原始 RNA 的那条链。这样做的好处是能区分正义链与反义链转录本——基因组上存在大量反义转录与重叠基因,没有链信息会直接把两个方向的表达量加在一起,定量结果不可信。常规 mRNA 项目默认走链特异建库。
04

样本要求

不建议直接寄送 RNA——能寄组织或细胞更好,由我方在实验前统一提取质检,样本不合格可以当场发现。

样本类型 RNA-seq
polyA 捕获链特异
RNA-seq
rRNA-delete
miRNA-seq circRNA-seq
RNA(自行提取)≥1 µg≥1 µg≥2 µg≥10 µg
细胞 · 数量≥1×10⁶ 个≥1×10⁶ 个≥2×10⁶ 个≥2×10⁷ 个
细胞 · 干体积≥5 µL≥5 µL≥5 µL≥20 µL
动物组织 · 心、脑、肾、肺≥30 mg≥30 mg≥50 mg≥500 mg
动物组织 · 肝、脾、胃≥10 mg≥10 mg≥20 mg≥200 mg
动物组织 · 皮肤、血管、骨等坚韧组织≥50 mg≥50 mg≥100 mg≥500 mg
动物组织 · 节肢动物≥50 mg≥50 mg≥100 mg≥500 mg
植物组织≥100 mg≥100 mg≥200 mg≥1 g
真菌干体积 ≥10 µL—干体积 ≥20 µL—
细菌—干体积 ≥10 µL——
血液 · 抗凝血(紫头)全血 ≥4 mL全血 ≥4 mL全血 ≥8 mL全血 ≥8 mL
血液 · 免疫细胞干体积 ≥10 µL干体积 ≥10 µL干体积 ≥20 µL干体积 ≥20 µL
血液 · 血清—≥2 mL≥1 mL—
血液 · 血浆—≥2 mL≥1 mL—
体液 · 精液≥3 mL≥3 mL≥5 mL—
自行提取 RNA 的质检标准:A260/A280 = 1.8–2.2、浓度 ≥100 ng/µL、总量 ≥1 µg、RIN ≥7、28S ≥1.5×18S;干冰运输,避免反复冻融。达不到标准时不要寄——降解的 RNA 建库成功率低,定量结果也会偏。
各类样本的通用处理要求:① 组织取新鲜组织,块尽量 ≤0.5 cm,预冷 PBS 或生理盐水洗去血迹,液氮速冻 1 h 后 −80 ℃ 保存,干冰运输;植物选健康幼嫩组织,70% 酒精冲洗表面后液氮速冻 20 min 以上。② 细胞用 TRIzol 充分裂解后 −80 ℃ 保存,一般 10 µL 细胞干体积对应约 1×10⁶ 个细胞。③ 全血用紫头 EDTA 抗凝管采集,冰袋 2–8 ℃ 运输,24 h 内送达。④ 真菌、细菌及其他特殊样本类型,请提前说明物种与培养条件后再评估。
三个最容易踩的坑:① 细胞不要连培养基一起冻,冰晶会刺破细胞,破碎细胞释放的核酸酶会把 RNA 降解掉;② 不要用胰酶消化细胞;③ 组织反复冻融会明显拉低 RIN,取样时就分好管,避免取用过程中来回化冻。

上表为四类建库方式的常规送样量下限,用于前期评估样本是否够用。完整版要求以最新版《武汉瑞兴生物科技有限公司送样规范》为准,其中还包含样本保存与运输细节、特殊组织取样建议、质检方法说明等内容;样本类型不在上表内、或送样量接近下限时,请先与技术顾问确认再寄样。

05

分析内容

标准分析 STANDARD

  1. 原始数据质控reads 质量、接头、GC 含量与重复性评估
  2. 比对与定量比对参考基因组,输出基因表达量矩阵
  3. 样本相关性检查PCA / 聚类与组内重复性评估
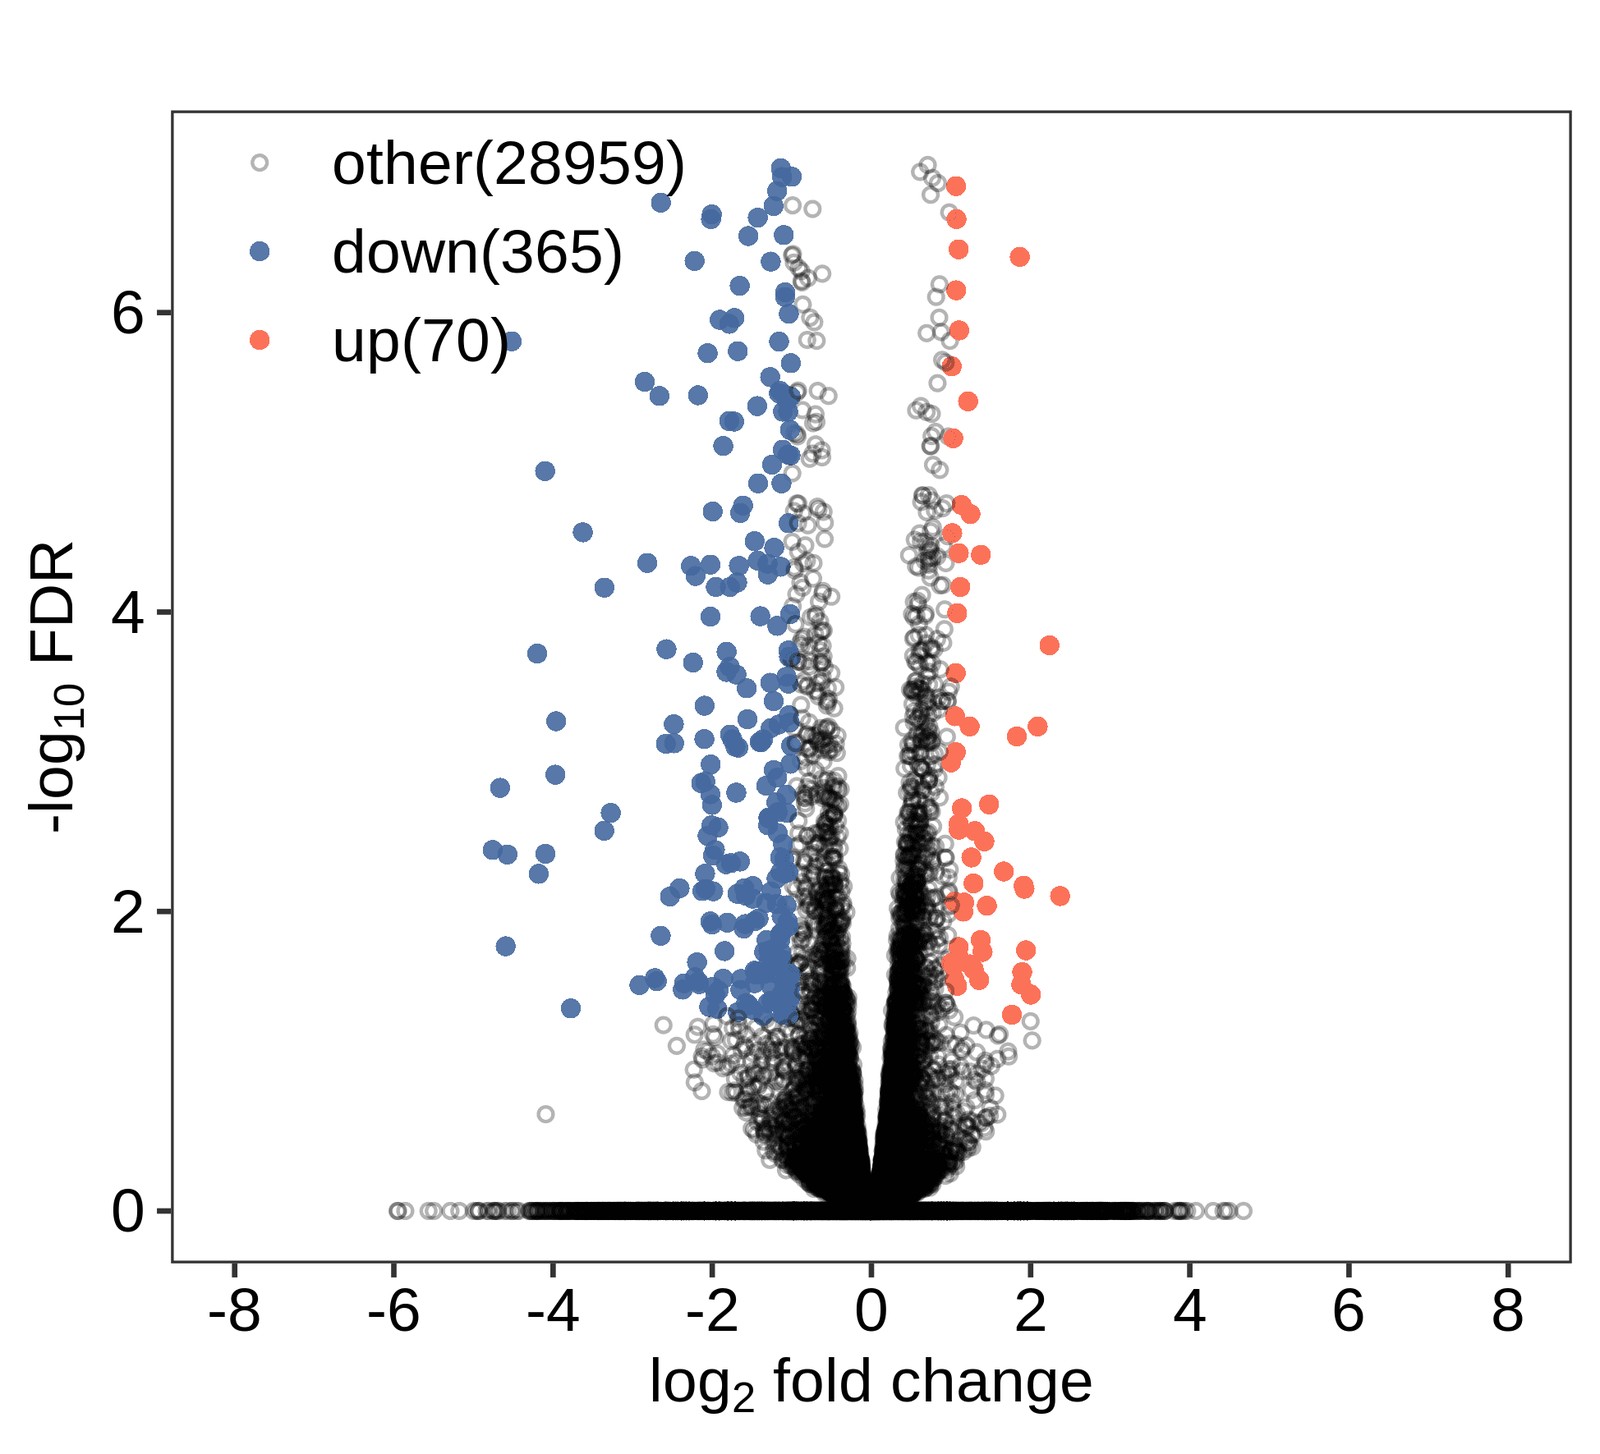
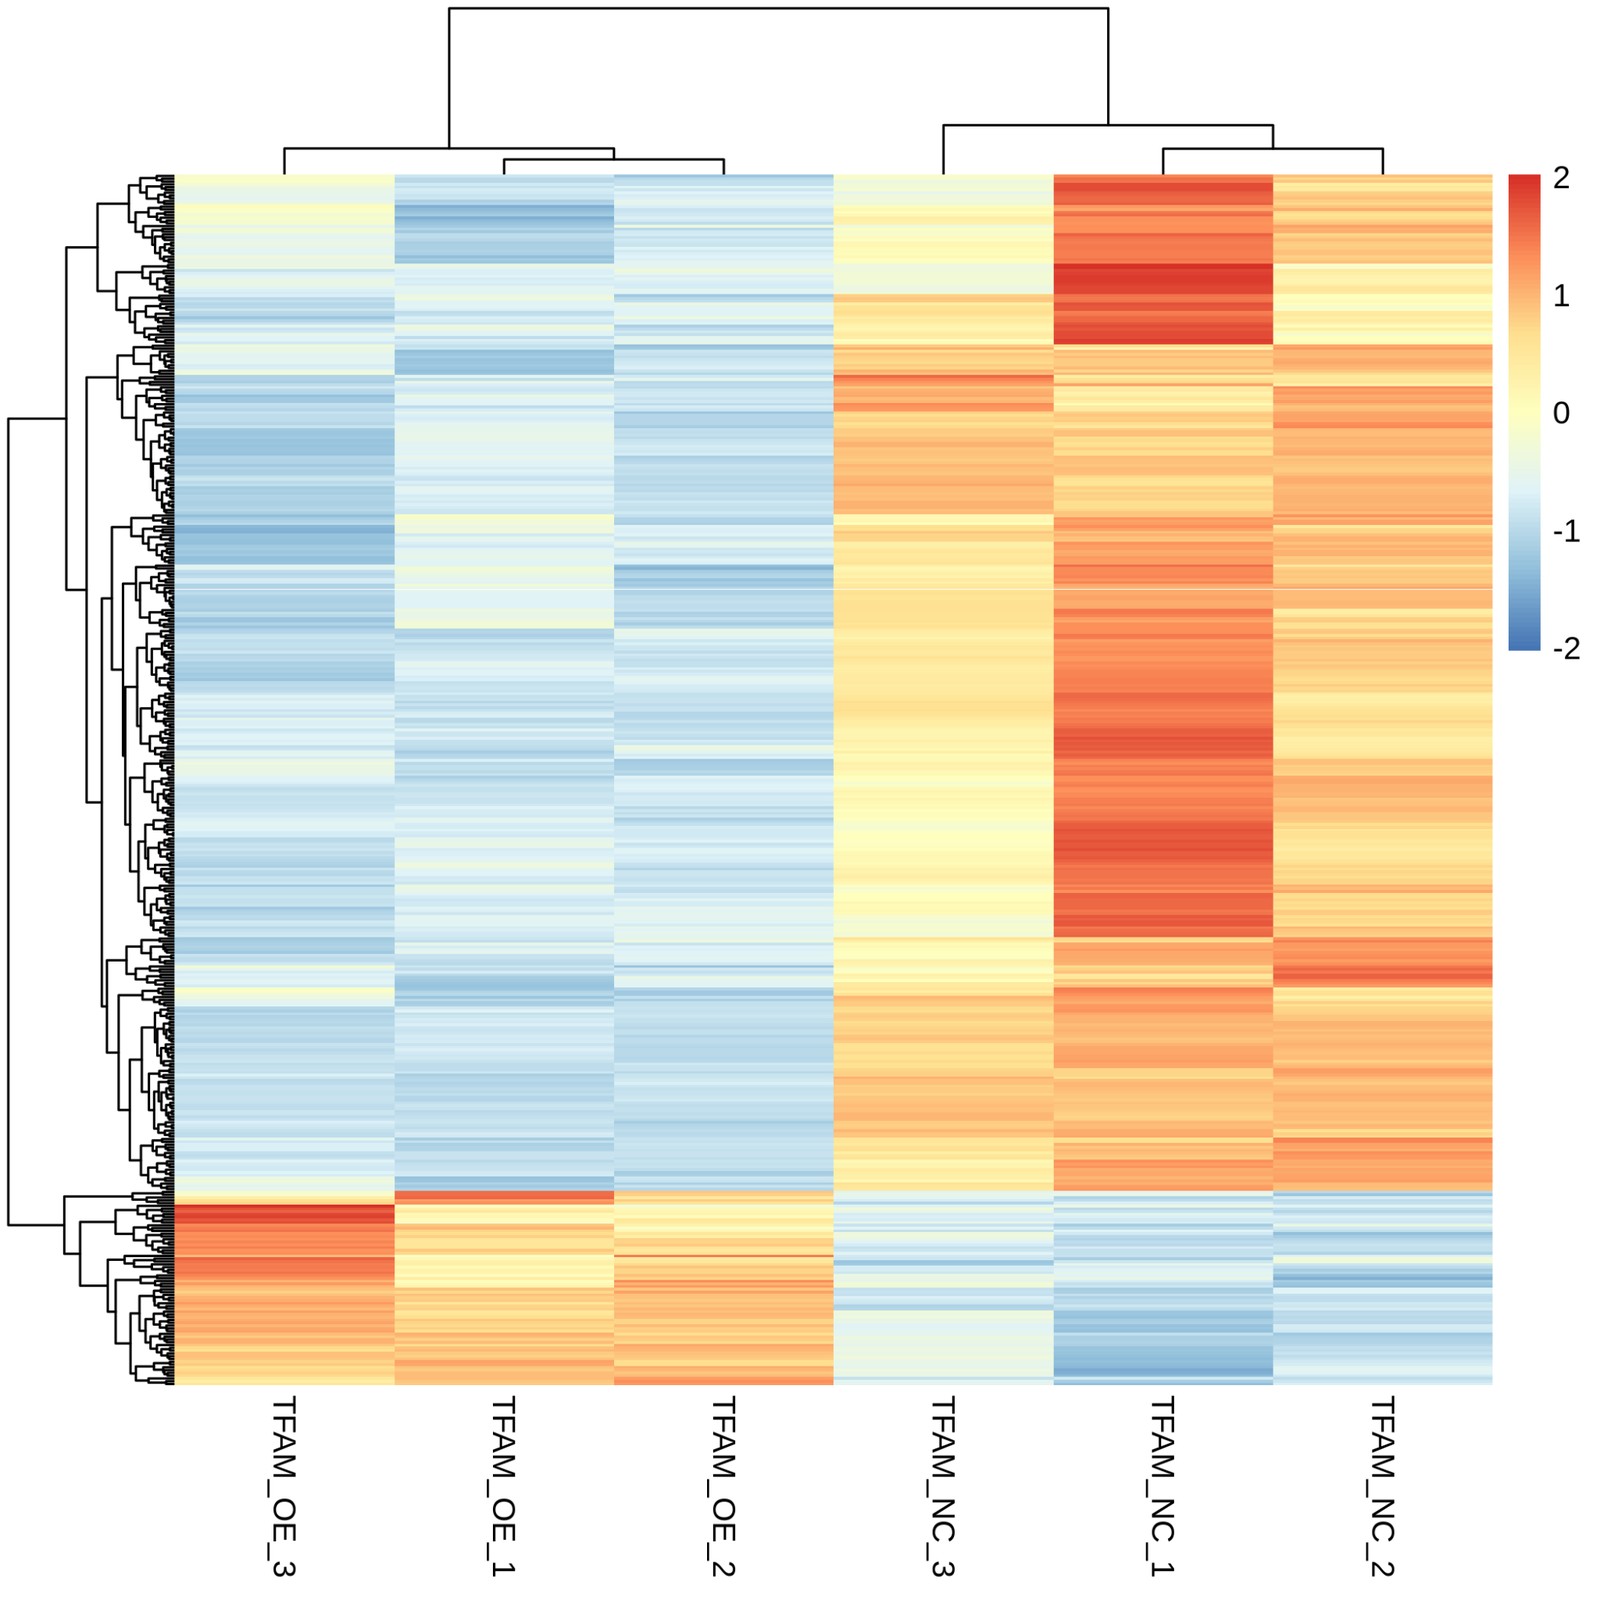
  4. 差异表达分析组间 DEG 筛选,输出差异基因列表与火山图 / 聚类图
  5. 可变剪接分析用自研 SUVA 流程按剪接位点使用变异定义 alt3p、alt5p、olp、contain、ir 五类事件,以 pSAR 与剪接比例差异筛选组间差异剪接事件
  6. 功能富集分析差异基因与差异剪接基因 GO、KEGG 富集与蛋白互作网络分析

高级分析 ADVANCED

  1. 共表达网络WGCNA 构建模块,关联表型与性状,锁定枢纽基因
  2. GSEA 与 GSVA基因集富集与通路活性评分,不依赖差异基因阈值
  3. 变异位点检测基于 RNA-seq 数据筛查 SNP / InDel 与等位基因表达
  4. 生存与临床关联结合公共数据库做预后分析与临床指标关联
  5. 多组学整合与蛋白组、代谢组、单细胞数据联合分析
关于 SUVA 可变剪接分析:SUVA(Splicing Site Usage Variation Analysis)是我司自主开发的剪接位点使用变异分析流程,按两个 junction 共享的剪接位点关系把可变剪接归为五类——alt3p(共享 5′ 剪接位点、3′ 端可变)、alt5p(共享 3′ 剪接位点、5′ 端可变)、olp(两端均不同但 junction 区域部分重叠)、contain(一个 junction 被另一个完整包含)、ir(内含子保留)。差异判定同时看两个量:剪接比例差异(splicing ratio difference)与 pSAR(该事件在该位点全部 reads 中的占比,用于判断事件是否真实可靠),流程同时输出经典剪接事件注释、新剪接位点与差异剪接事件表。方法学见 Cheng et al., RNA Biology 2021, 18(Suppl 1): 157–171,流程代码见 github.com/ablifedev/SUVA。
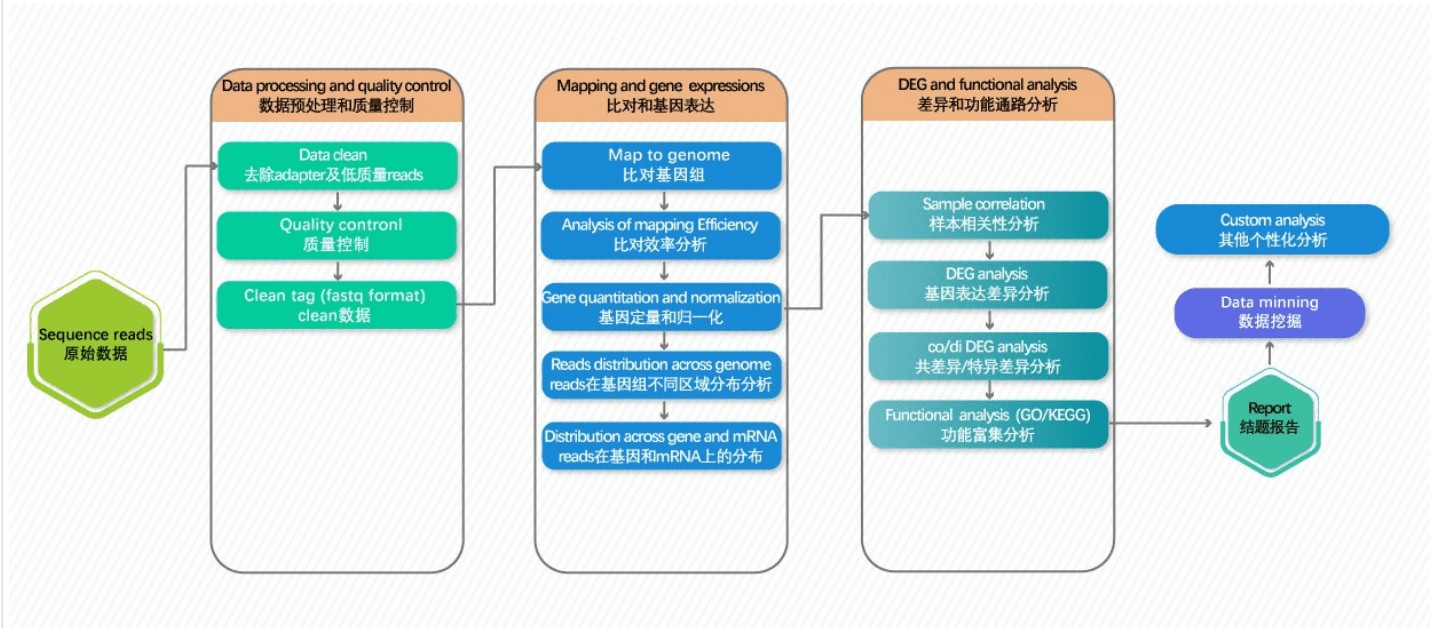
RNA-seq 生物信息分析流程:数据质控、比对参考基因组、表达定量、差异表达、可变剪接与功能富集
RNA-seq 分析流程:质控 → 比对 → 定量 → 差异表达 → 可变剪接 → 富集
RNA-seq 差异基因火山图,横轴为表达倍数变化,纵轴为显著性
差异基因火山图:上下调基因分布与显著性
RNA-seq 差异基因聚类热图,按表达模式对样本与基因聚类
差异基因聚类图:样本分组与基因表达模式
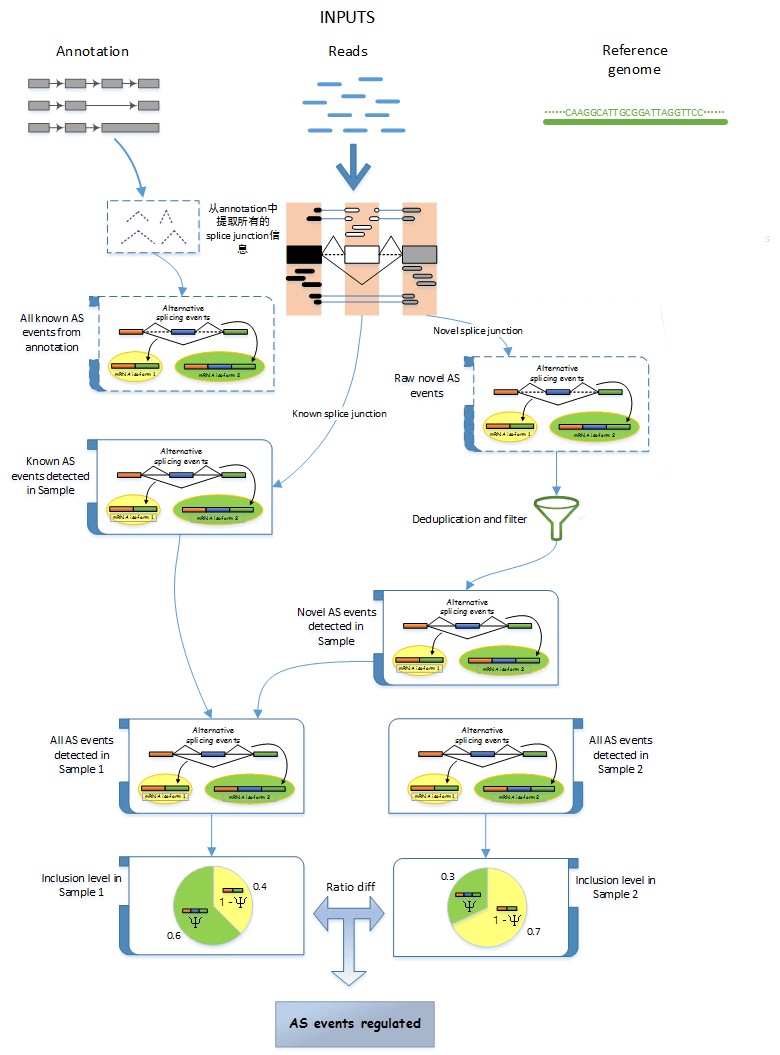
RNA-seq 数据差异可变剪接分析流程图
RNA-seq 数据差异可变剪接分析流程
06

应用案例

项目案例一
IF 7.3 Oncogene · 骨肉瘤可变剪接

KPNA2 promotes osteosarcoma progression by regulating the alternative splicing of DDX3X mediated by YBX1

KPNA2 通过调节 YBX1 介导的 DDX3X 可变剪接促进骨肉瘤进展

期刊:Oncogene(IF 7.3,2024 JCR Q1) · 发表时间:2025 年 7 月(Vol 44, 2186–2200) · 团队:武汉协和医院
阅读原文:doi.org/10.1038/s41388-025-03375-3

样本:骨肉瘤公共 mRNA-seq 数据集 GSE87624(44 例——23 例原发性骨肉瘤、8 例转移性骨肉瘤、3 例正常骨组织);两种骨肉瘤细胞系(U2OS、MNNG/HOS)野生型与 YBX1 敲低组 RNA-seq;TCGA 与单细胞数据集 GSE152048 用于验证

瑞兴支持:本项目由我司提供可变剪接分析支持。使用自主开发的 SUVA 可变剪接分析流程完成差异剪接全景解析与 RBP-AS 共表达网络构建,产出课题前期核心数据。

研究发现:可变剪接全景分析显示,骨肉瘤中剪接事件显著异常,其中 5′ 剪接位点(alt5p)与 3′ 剪接位点(alt3p)事件最为突出,alt5′ss 是骨肉瘤中发生频率最高的事件类型;493 个剪接事件在原发性骨肉瘤中特异性表达,174 个在原发性与转移性样本中均显著,功能富集指向细胞周期与有丝分裂。差异剪接基因与 RNA 结合蛋白的共表达分析从 2,141 个 RBP 中鉴定出 71 个差异表达的 RBP,其中 25 个与 106 个剪接事件显著共表达,据此构建骨肉瘤特异的 RBP-AS 共表达网络,锁定 KPNA2 为关键枢纽基因、YBX1 为其互作剪接因子,TCGA 生存分析证实二者的预后价值。

对 YBX1 敲低细胞系的 RNA-seq 显示,YBX1 主要调控内含子保留(IR)事件,差异基因富集于 RNA 剪接、细胞周期与无义介导的 mRNA 衰变(NMD)通路。机制链条为:KPNA2 负责把 YBX1 转运进细胞核 → YBX1 结合 DDX3X 内含子 17 并促进其保留 → 含内含子的转录本经 NMD 途径降解 → DDX3X 蛋白水平下降 → CDK2、AKT1 上升而 p21 下降,细胞周期加速,最终推动骨肉瘤进展。

项目案例二
IF 13.0 Journal of Advanced Research · 慢性髓系白血病

Transcriptome profiling reveals the high incidence of hnRNPA1 exon 8 inclusion in chronic myeloid leukemia

转录组分析揭示慢性髓系白血病中 hnRNPA1 外显子 8 包含的高发生率

期刊:Journal of Advanced Research(IF 13.0,2024 JCR) · 发表时间:2020 年 7 月(Vol 24, 301–310)
阅读原文:doi.org/10.1016/j.jare.2020.04.016

样本:外周血单核细胞(PBMC)——5 例慢性期(CP)CML 患者、5 例急变期(BP)患者与 5 例健康对照 · 方法:RNA-seq 差异表达与可变剪接分析

瑞兴支持:本项目由我司提供 RNA-seq 及可变剪接分析支持。

研究发现:该研究利用转录组测序技术揭示了不同时期慢性髓系白血病患者的转录图谱。全局剪接改变分析在 CML 与健康样本之间检出 6,474 个改变的可变剪接事件,其中既包含此前已报道的剪接变异体,也显示急变期样本的剪接失调更为严重。差异剪接基因的功能聚类显示:慢性期主要富集于细胞信号相关通路,而急变期中 剪接体(spliceosome)通路最为突出。

其中一个差异剪接的剪接体基因 hnRNPA1 表现出两种剪接亚型:包含外显子 8 的长亚型在急变期患者中优先表达,而不含外显子 8 的短亚型则特异性地出现在健康对照中。作者据此提出,可变剪接失调在 CML 从慢性期向急变期进展中起核心作用,hnRNPA1 的长亚型可能成为 CML 的诊断标志物与治疗靶点。

07

常见问题

RNA-seq 和三代全长转录组怎么选?
看问题出在哪一层。如果关心的是基因表达量的高低,RNA-seq 足够,性价比也更高。如果关心的是isoform 结构、剪接事件的完整链条、APA 位点,或者物种注释不全,短读长只能靠组装推测,需要补长读长测序(如 ONT-lrRNA-seq)。常见做法是先跑 RNA-seq 做定量和筛选,再对关键样本补长读长定结构。
需要多少生物学重复?测序量多大?
差异表达分析建议每组至少 3 个生物学重复,这是统计推断的最低要求;只做表达谱普查时 2 个也可以。常规转录组建议每个样本 6 G 以上 clean data,低表达基因或差异较小的项目可提高到 10–12 G。具体按物种复杂度与目标基因丰度评估。
可以只寄提取好的 RNA 吗?
可以,但不建议。RNA 在提取、分装、干冰运输环节里降解风险高,一旦 RIN 掉到 7 以下就要重新取样。寄组织或细胞,由我方在实验前统一提取质检,样本不合格可以当场发现。确实只能寄 RNA 时,请一并提供浓度、OD260/280 和电泳或 Agilent 2100 的质检结果。
非模式物种、没有参考基因组能做吗?
能做。没有参考基因组时可用 de novo 方式直接拼装转录本,再做功能注释;有近缘物种基因组时也可以比对过去。请提前说明物种、倍性和组织类型,方便评估 RNA 提取难度(植物、真菌、高多糖高酚样本需要调整方案)。
RIN 达不到 7 怎么办?
先看样本类型。部分特殊物种本来就没有明显的 28S 条带,RIN 算法会失真,这种情况以 Agilent 2100 的基线是否平整为准。真降解的样本建议重新取样——降解样本会直接表现为 reads 分布偏向转录本 3′ 端,定量偏差难以校正。
除 mRNA 之外还想看 lncRNA、circRNA、miRNA,怎么办?
可通过全转录组测序一次覆盖:用两种建库方式对 pre-mRNA、lncRNA、circRNA 或 miRNA 分别测序并单独分析,也可做多种 RNA 的联合分析与内源竞争性 RNA(ceRNA)整合分析。若只关注某一类,如 miRNA 或 circRNA,也可单独建库,请说明研究目标后由我们给出方案。
SUVA 和 rMATS 那套 SE / A5SS / A3SS / MXE / RI 是什么关系?
两套分类的依据不同,事件名不能一一对应。rMATS 一类工具按「已知模式」给事件贴标签,只认 SE、A5SS、A3SS、MXE、RI 这五种预定义模式,落在模式之外的 junction 就被丢弃。SUVA 从 junction 出发,看两个 junction 之间共享了哪个剪接位点来定义事件(alt3p、alt5p、olp、contain、ir),因此能覆盖到部分重叠、包含这类复杂情况,也能识别注释以外的新剪接位点。判定口径也不同:SUVA 同时看剪接比例差异与 pSAR(事件在该位点全部 reads 中的占比),pSAR 低的事件会被过滤掉,不做无意义的强行比较。如果此前已经用其他流程出过结果,可以并行跑一遍 SUVA 做交叉验证。
Get A Solution

获得技术方案

您有任何关于组学测序的项目问题,请留言给我们。技术团队将在工作日 24 小时内给您答复。

项目咨询

技术顾问对接具体课题,先讨论科学问题再谈检测清单

027-87050299

sales@rxbio.cc

寄样收样

李欣 13237124769
武汉市东湖高新区高新二路 388 号光谷生物医药加速器 18 栋 1-2 层

提交您的项目需求

填写以下信息,我们会尽快与您联系并给出技术方案建议。

提交即表示同意我们通过电话或邮件与您联系,仅用于项目沟通。