跳到主要内容

瑞兴生物RXBio

多组学技术服务与深度数据挖掘 · 从研究设计到实验验证的全流程支持
Oxford Nanopore · 三代测序

全长全基因组重测序 ONT-lrWGRS

基因组里最难测的地方,恰恰常常是最要紧的地方:大段重复序列、片段重复、GC 富集区、复杂重排。短读长测到这些区域就"迷路"——150 bp 的片段落进一段几 kb 的重复里,不知道该放回哪个位置。长读长一条 read 就能跨过整段重复,断点两端都读到,结构变异也就不必靠推断。

  • 超长读长跨重复区
  • 无 PCR 偏差
  • SNP / InDel / CNV / SV
  • 单倍型分型
  • 同时测碱基修饰
≥5µg DNAgDNA 起送量
无PCR不扩增,无 GC 偏好与扩增偏差
4类变异SNP / InDel / CNV / SV
修饰同测变异之外可检 DNA 甲基化
01

技术简介

全基因组重测序(Resequencing)是对已有参考基因组序列的物种个体做基因组测序,通过与参考序列比对,分析个体或群体之间的基因组差异。它能一次性覆盖多种变异类型:单核苷酸多态性(SNP)、拷贝数变异(CNV)、插入缺失(InDel)以及结构变异(SV),因此被广泛用于临床医药研究、群体遗传学、关联分析和进化分析。

二代测序(NGS)做这件事有两个绕不开的限制。一是读长 ≤300 bp:遇到重复序列和复杂结构变异,短片段无法唯一定位,只能放回"多个可能位置"里挑一个,或者直接被过滤掉。二是PCR 扩增偏差:扩增对 GC 含量敏感,高 GC 区域覆盖度掉下去,CNV 这类依赖覆盖深度均一性的检测灵敏度随之下降。

三代长读长测序(LRS)针对的正是这两点:超长读长能完整跨过复杂重复区域,断点两端落在同一条 read 上,结构变异是"读到"的而不是"推出来"的;无需 PCR 扩增(纳米孔为单分子测序),覆盖均匀性不受 GC 偏好影响;现有平台的单分子一致性准确率已支持临床级应用,在结构变异检出和单倍型分型上的优势尤其明显。

ONT-lrWGRS 是利用牛津纳米孔技术对基因组 DNA 进行直接测序的方法。除变异信息外,还能从同一批数据里检测碱基修饰(如甲基化),适用于基因组组装、结构变异鉴定和表观遗传学研究,且具有实时、快速的特点。

02

技术优势

高变异检出率

无需 PCR 扩增,无 GC 偏好,超长读长能轻松跨过高重复和高复杂度区域。这类区域在短读长数据里通常是覆盖空洞或误比对的重灾区,恰恰是长读长提升最明显的地方。

精确的变异信息

超长读长为检测大片段结构变异(SV)提供保障。缺失、插入、重复、倒位的断点在短读长里只能靠覆盖深度突变或异常比对片段推断,长读长则能直接读到断点序列,位置和大小都更准。

更丰富的分析内容

除 SNP、InDel、CNV、SV 这些变异信息外,还能检测 DNA 上的各类碱基修饰,并支持单倍型分型。一份数据覆盖遗传变异与表观修饰两层,不用分别建库。

03

技术原理

测序环节和所有纳米孔测序一样:单链 DNA 在分子马达牵引下穿过纳米孔,孔内碱基引起特征性电流变化,仪器按电流轨迹判读碱基序列。因为是单分子测序,不需要先扩增出一堆拷贝,也就不会引入扩增偏差。

决定 lrWGRS 能力的是读长分布。只要 DNA 提取时把片段保住(送样规范要求 5 kb 以下无明显小片段),一条 read 就能覆盖几千到几万个碱基,从而完整跨过:串联重复扩张、片段重复(segmental duplication)、转座元件插入、以及复杂的染色体重排断点。

同一个分子上的信息是连着的,这一点带来了短读长难以实现的分析——单倍型分型。相隔几千碱基的两个杂合位点是否在同一条染色体上,长读长一条 read 就能回答;短读长只能靠群体频率做统计推断。

04

实验流程

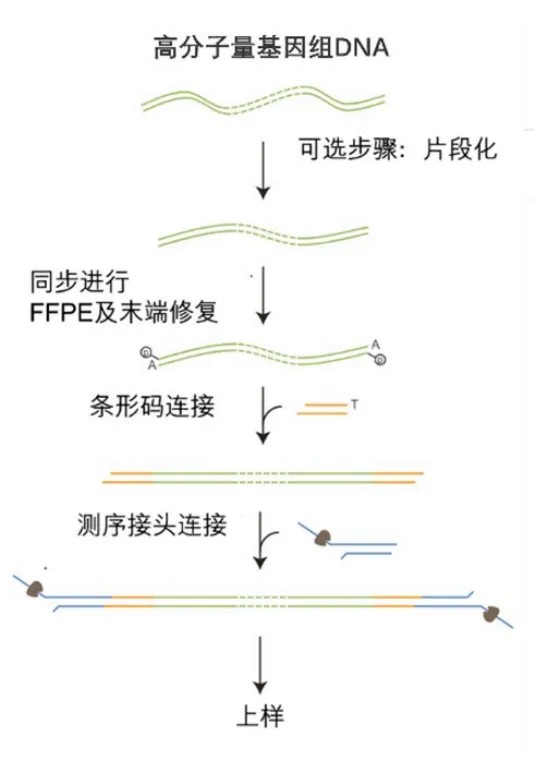
1. 文库构建原理

1

提取高质量 gDNA

提取高质量基因组 DNA

2

片段化(可选)

对 DNA 样本进行打断;若片段长度已合适可跳过

3

末端修复与加 A

末端修复并在 3′ 端加 A

4

连接 Barcode

连接样本 Barcode,用于多样本混样区分

5

连接测序接头

连接测序接头

6

上机测序

加载到测序芯片上进行测序

ONT 全基因组重测序文库构建流程图:提取 gDNA、片段化、末端修复加 A、连接 Barcode、连接测序接头、上机测序
ONT 全基因组重测序文库构建流程

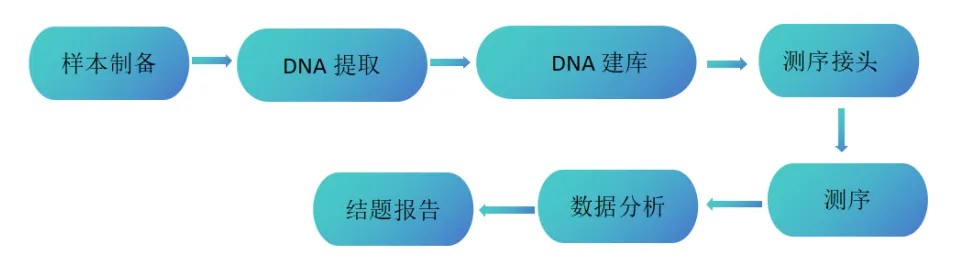
2. 技术路线

ONT 全长全基因组重测序技术路线:从样本接收到质检、建库、测序、变异检测到功能注释的完整流程
ONT-lrWGRS 技术路线
05

送样要求

长读长重测序对 DNA 片段长度的要求比二代高,这一项请在送样前重点确认。

样本类型ONT-lrWGRS说明
DNA 总量≥5 µg由我方提取时按下表组织量送样
DNA 纯度OD260/280 1.7–1.9;OD260/230 2.0–2.2230 比值偏低提示胍盐、酚或糖类残留
DNA 完整性核心琼脂糖凝胶电泳 5 kb 以下无小片段;片段大小检测仪器(Qseq / Agilent 2100)在 5 kb 以下无明显峰长读长项目的第一道关;片段短了,跨重复和检 SV 的能力直接打折
细胞≥1×10⁷ 个由我方提取 gDNA 更稳妥
动物组织 · 心、脑、肾、肺≥50 mg取新鲜组织,块尽量 ≤0.5 cm;去除结缔组织与脂肪;预冷 1×PBS 或生理盐水洗去血迹,液氮速冻后 −80 ℃ 保存,干冰运输,避免反复冻融
动物组织 · 肝、脾、胃≥20 mg
动物组织 · 皮肤、血管、软骨、骨等坚韧组织≥100 mg
植物组织≥500 mg植物多糖多酚干扰提取,取样量需加大
全血4 mL按血液样本常规采血管要求采集与运输
免疫细胞干体积 ≥20 µL一般 10 µL 细胞干体积对应约 1×10⁶ 个细胞
取样环节最该注意的一件事:保住长片段。长读长测序的能力上限由你送来的 DNA 片段长度决定,实验环节只能保住它、无法补救。提取时避免剧烈涡旋和反复吸打,用宽口枪头轻柔操作;样本分装保存,一次取一管,不要反复冻融。做完提取先跑一次电泳或 Qseq 看 5 kb 以下有没有拖尾,再决定寄样。
06

分析内容

标准分析 STANDARD

  1. 数据质控与比对reads 质控、长度分布、比对到参考基因组、覆盖度统计
  2. SNP / InDel 检测单核苷酸变异与小片段插入缺失的检出与注释
  3. 结构变异 SV 检测DEL / INS / DUP / INV 四类结构变异的断点鉴定
  4. 拷贝数变异 CNV基于覆盖深度与断点信号的 CNV 检出
  5. 变异功能注释变异落在 CDS / UTR / 启动子 / 内含子的分布与影响预测

高级分析 ADVANCED

  1. 单倍型分型同一条 read 上的杂合位点连锁,构建单倍型区块
  2. 复杂 SV 与重排解析复杂结构变异、染色体平衡易位与重排模式
  3. DNA 碱基修饰检测甲基化等修饰位点与修饰水平
  4. 群体遗传与选择分析群体结构 PCA、FST / PBS 选择信号
  5. 变异与表型关联与临床表型、GWAS catalog、OMIM、COSMIC 等数据库交叉注释
07

应用案例

案例一
IF 15.7 Nature Communications · 中国人群 SV

Structural variants in the Chinese population and their impact on phenotypes, diseases and population adaptation

中国人群的结构变异及其对表型、疾病和群体适应的影响

期刊:Nature Communications(IF 15.7) · 发表时间:2021 年
样本:405 人(男性 206 人、女性 199 人),年龄 22–81 岁 · 测序平台:Oxford Nanopore PromethION
阅读原文:doi.org/10.1038/s41467-021-26856-x

研究设计:作者基于 ONT 平台做全基因组长读长测序,同时通过健康筛查收集其中 327 个个体的 68 项表型与临床测量值,把基因组数据与表型数据合成一个数据库。数据质控后比对到 GRCh38,检测长度 ≥50 bp 的缺失(DEL)、插入(INS)、重复(DUP)和倒位(INV)四类结构变异。
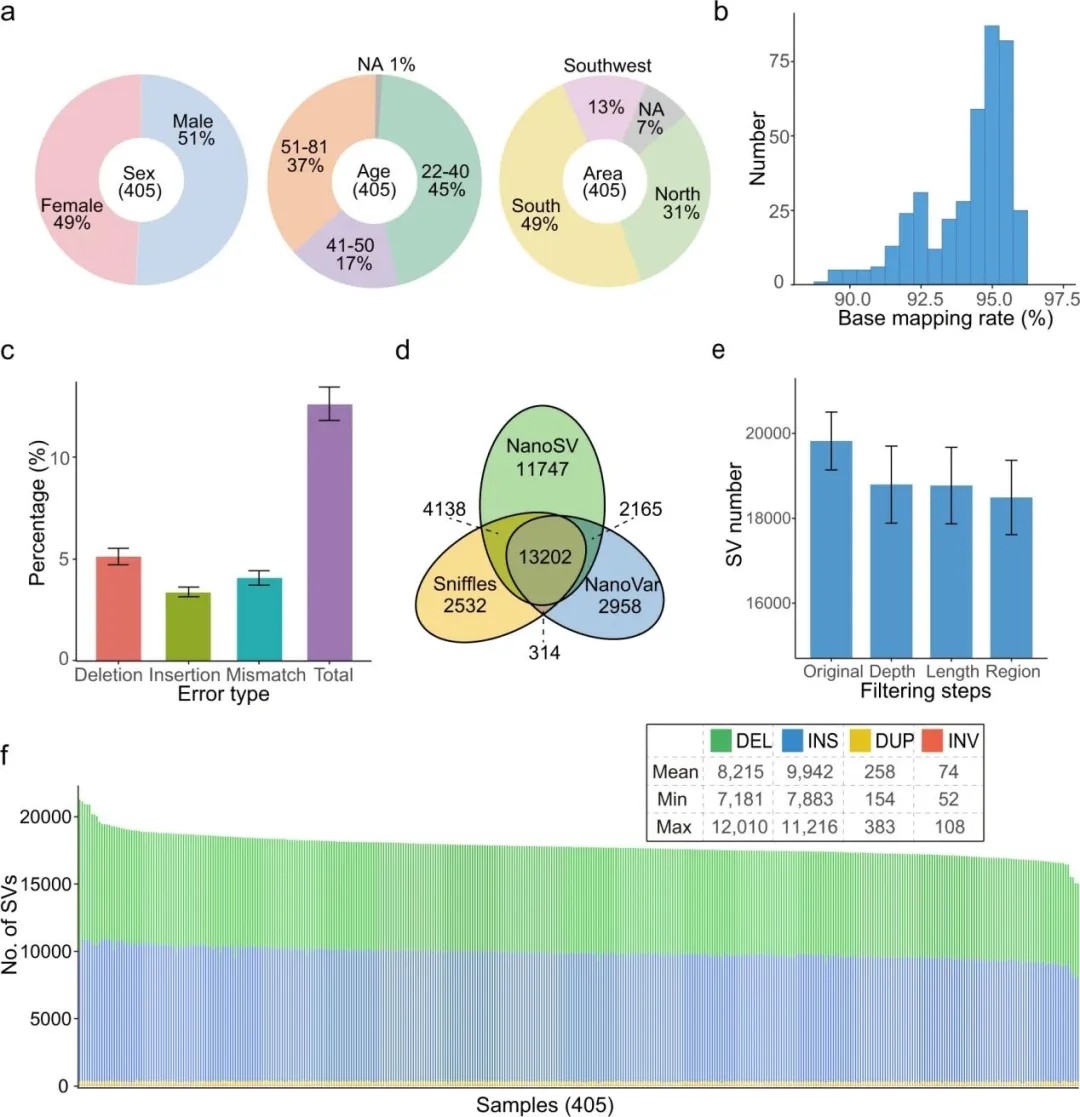
中国人群结构变异数量分布:平均每样本检出 18489 个高置信 SV,测序深度超过 15 倍后 SV 数量趋于饱和
每样本平均 18,489 个高置信 SV;深度超 15× 后数量趋于饱和

可靠性控制:为压低假阳性,作者用 Sniffles、NanoVar 和 NanoSV 三种长读长分型方法交叉验证,只保留至少被两种方法识别的 SV。结果平均每样本鉴定出 18,489 个高置信 SV,数量近似正态分布,以 DEL 和 INS 为主。深度实验显示,测序深度超过 15 倍后 SV 数量增长趋于饱和——说明再往上加深度,新增的 SV 越来越少,这对项目预算规划是个可直接引用的参考。
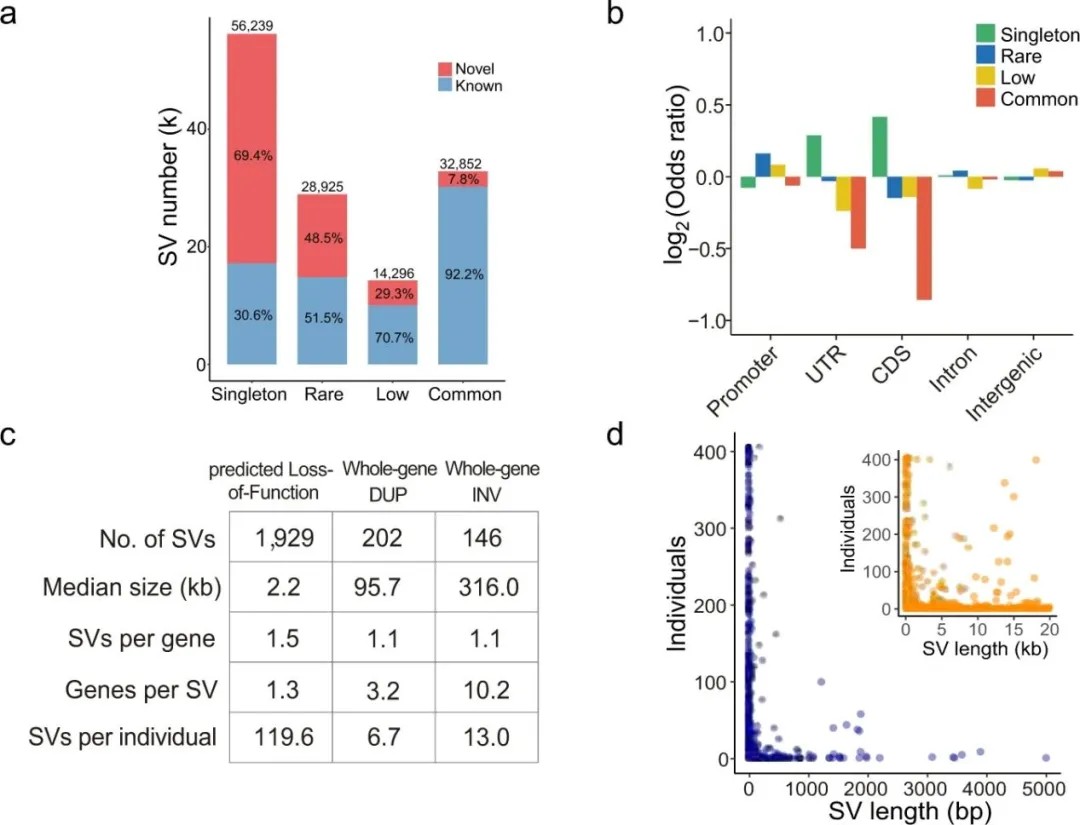
结构变异的功能注释:内含子区占比最高,UTR 与 CDS 区单例 SV 显著富集,CDS 重叠 SV 分为 pLoF、WDUP、WINV 三亚型
功能注释:UTR / CDS 区单例 SV 富集;CDS 重叠 SV 分 pLoF / WDUP / WINV

功能注释:按基因组位置注释后,内含子区 SV 占比最高;UTR 和 CDS 区里,单例 SV(只在单个样本中检出)显著富集,提示这部分变异承受着更强的选择压力。与 CDS 重叠的 SV 按断点位置进一步分成三亚型:预测功能丧失型(pLoF)——造成编码核苷酸缺失或开放阅读框改变;全基因复制型(WDUP)——导致整个基因拷贝数增加;全基因倒位型(WINV)——通过重组上游增强子与基因的位置或方向来调控表达。受 pLoF SV 影响的 38 个基因在"免疫球蛋白受体结合"通路显著富集。
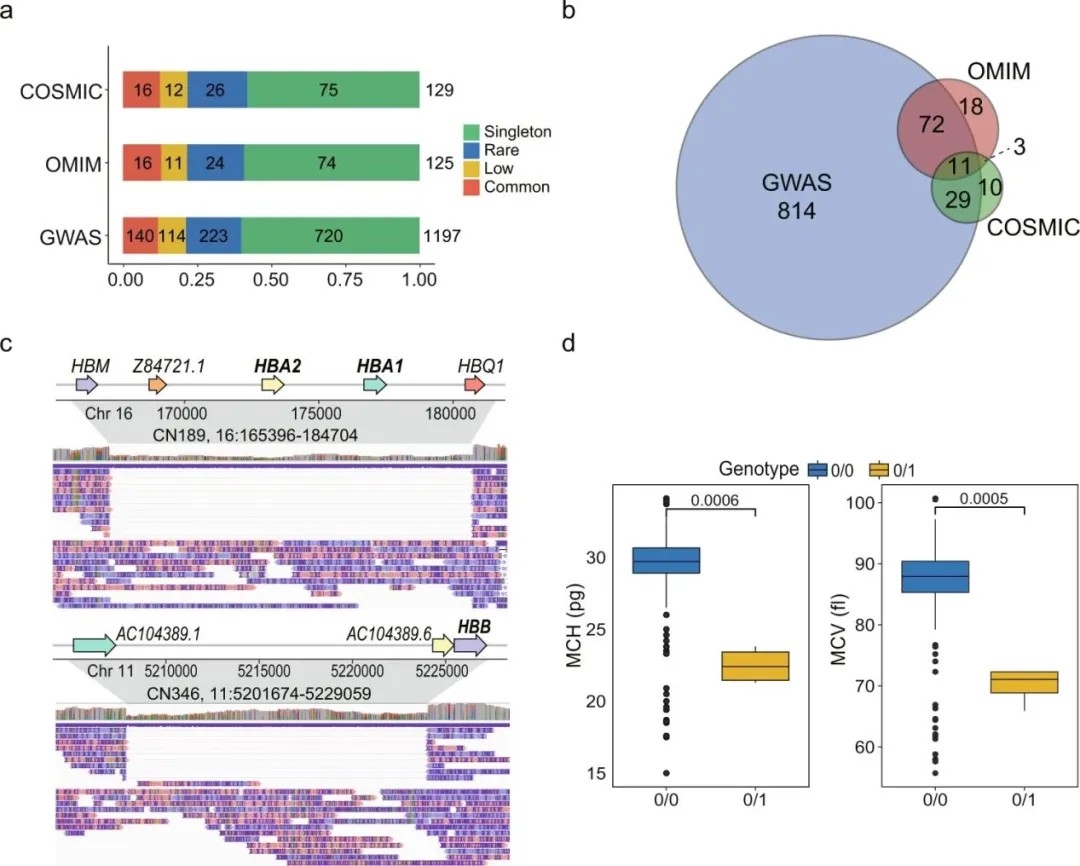
与疾病相关的结构变异实例:19.3 kb DEL 覆盖 HBA1 与 HBA2 导致 alpha 地中海贫血,27.4 kb DEL 含 HBB 引起镰状细胞贫血与 beta 地中海贫血
疾病关联:HBA1/HBA2 区 19.3 kb 缺失与 HBB 区 27.4 kb 缺失

与疾病的关联:作者用 GWAS catalog、OMIM 和 COSMIC 数据库注释了 SV 及其相关基因。一个 19.3 kb 的杂合罕见缺失覆盖了血红蛋白 α 亚基基因 HBA1 和 HBA2,其功能丧失会导致 α-地中海贫血;一个 27.4 kb 的杂合缺失包含血红蛋白 β 亚基基因 HBB,功能丧失会引起镰状细胞贫血和 β-地中海贫血等严重血红蛋白病。在 gnomAD 数据库中,这个 19.3 kb 缺失序列有 92.3% 来自东亚群体,说明它具有明显的群体特异性。此外,作者基于 MAF > 0.05 的基因分型 SV 做了生化、血液和尿液组成等临床表型的 GWAS。
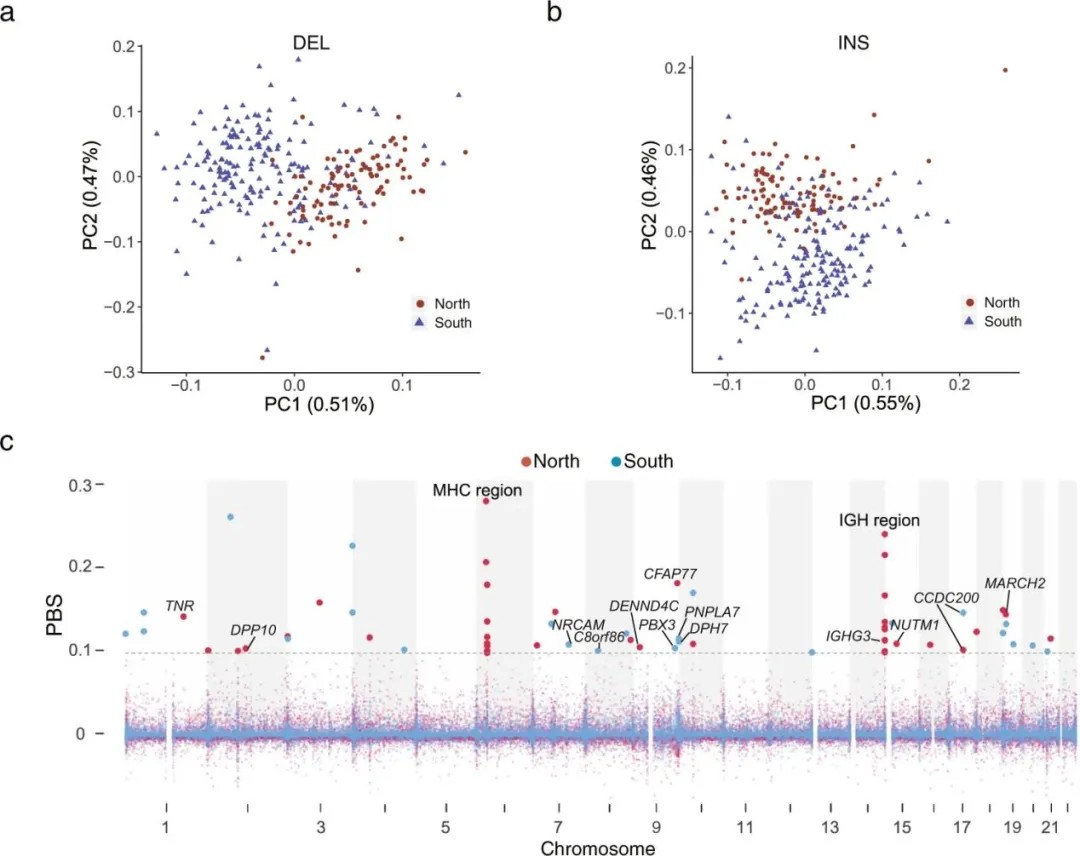
中国南北方群体的群体遗传分析:PCA 显示遗传多样性差异,FST 与 PBS 在 MHC 与 IGH 区域检出选择信号
南北方群体选择信号集中在 MHC 与 IGH 免疫相关区域

群体适应:此前 SNP 芯片和短读长 WGS 已经揭示过中国南北方个体的遗传差异;本研究用 FST 和 PBS 分别在中国北方和南方人群基因组中检出 24 个和 35 个独立的 PBS 信号。北方人群中前两个信号位于主要组织相容性复合体(MHC)区域 6p21.3-p22.1 和免疫球蛋白重链(IGH)簇基因座 14q32.33——MHC 区域内带 PBS 信号的 9 个 SV 落在 HLA-G、HLA-A、HLA-DRA、HLA-DRB5、HLA-DRB1、HLA-DQA1、HLA-DPA1 的基因间区;IGH 簇基因座中有 10 个带信号的 SV。南方人群同样在 MHC 和 IGH 区域检出 PBS 信号,提示免疫相关区域的 SV 可能与长期暴露于不同环境有关。另一个带 PBS 信号的 1.4 kb 插入位于 PNPLA7 基因第 13 内含子,而 PNPLA7 此前通过 RNA 测序分析被关联到高血压,中国北方人群的血压和高血压患病率高于南方——不过作者也指出,这个插入是否真能引起基因表达变化、进而影响血压,还需要更多证据。
案例二
IF 29.0 Nature Genetics · 重复扩张

Long-read sequencing identifies GGC repeat expansions in NOTCH2NLC associated with neuronal intranuclear inclusion disease

长读长测序在 NOTCH2NLC 中鉴定出与神经元核内包涵病相关的 GGC 重复扩增

期刊:Nature Genetics(IF 29.0) · 发表时间:2019 年
样本:8 个家系的 13 例患者 + 4 例正常个体 · 测序平台:Oxford Nanopore PromethION(1 例用 PacBio RSII)
阅读原文:doi.org/10.1038/s41588-019-0459-y

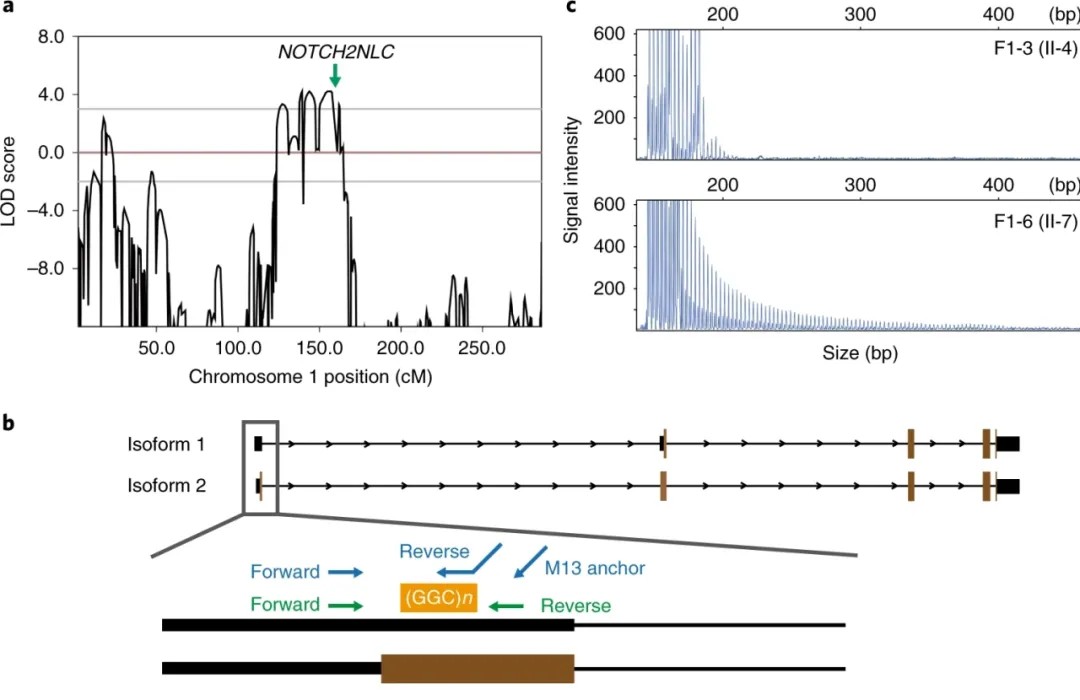
连锁分析定位致病区间:二代全基因组与全外显子测序未找到致病 SNP 或 CNV,连锁分析定位到 1p36.31-p36.22 与 1p22.1-q21.3 两个区域
二代 WGS / WES 未找到致病变异,连锁分析把范围缩到两个区间

短读长的死角:研究者先对家系 1 的患者和正常个体做了二代全基因组测序(WGS)或全外显子组测序(WES),连锁分析把致病位点定位在 1p36.31-p36.22(约 3.5 Mb,最大 LOD 2.32)和 1p22.1-q21.3(约 58.1 Mb,最大 LOD 4.21)两个区域,但在二代 WGS 和 WES 数据中没有发现致病性的 SNP 或 CNV。

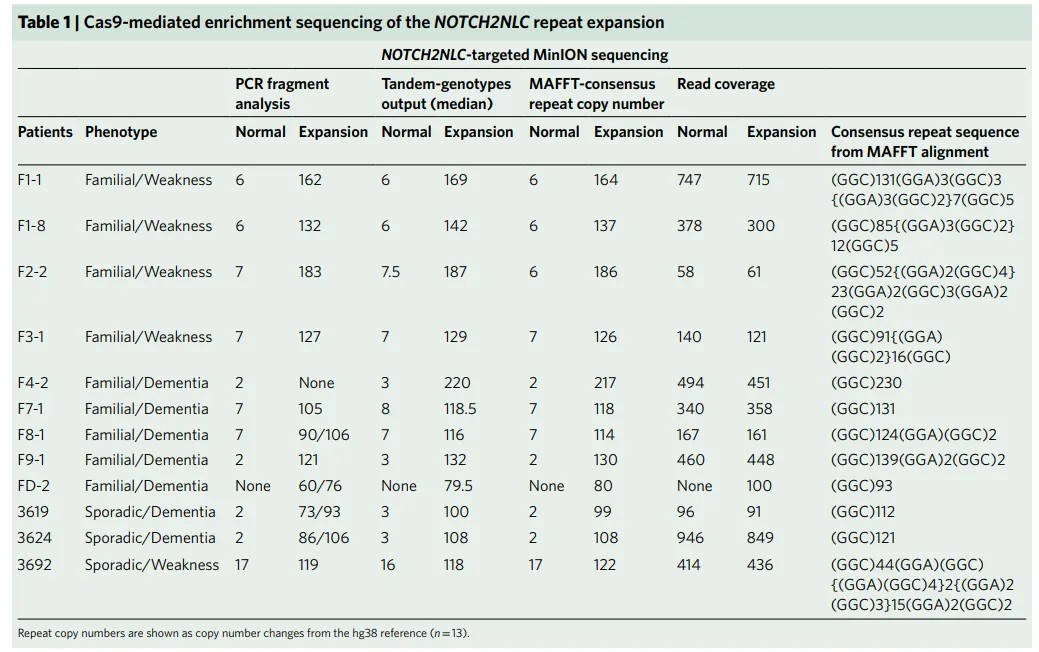
三代测序在 NOTCH2NLC 基因 5 UTR 检出 GGC 重复扩增,重复序列中可能还包含 GGA 单元
chr1:149390802-149390842 处 GGC 重复扩增,位于 NOTCH2NLC 的 5′UTR

长读长找到的致病变异:随后研究者用三代测序对 8 个家系的 13 例患者和 4 例正常个体做了全基因组测序(除 F1-6 用 PacBio RSII 外,其余均用 ONT PromethION)。结果 13 例患者在 chr1:149390802-149390842 处都存在 GGC 重复扩增,该扩增位于 NOTCH2NLC 基因(NM_001364012)的 5′UTR,落在 58.1 Mb 的连锁区间内。进一步分析发现,重复序列中除 GGC 单元外还可能包含 GGA 单元——家系 1、2、3 的患者数据中都有 reads 支持 GGA 的存在,F1-6 的 PacBio reads 中同样检出。

为什么短读长看不到:NOTCH2NLC 位于 1q21.1,是三个人类特有的 NOTCH2NL 基因之一,在神经胶质细胞、星形胶质细胞和小胶质细胞等多种神经细胞中高表达,被认为参与人类大脑皮层的进化。三个 NOTCH2NL 基因之间序列高度相似,且多为 GC-rich 区域,短读长测序难以分析这类同源和重复区域;长读长对这类区域有明显优势。本研究还发现,用 Nanopore PromethION 对 NIID 患者做全基因组测序,即使在约 8× 的低覆盖度下也能检出 NOTCH2NLC 基因中的重复扩张序列。此外,作者用 Nanopore 数据分析了 GGC 重复扩张序列的甲基化水平,发现扩增区域与未扩增区域之间甲基化水平没有差异,因此认为由 GGC 扩增导致 CpG 甲基化、进而使 NOTCH2NLC 功能丧失的可能性较小。

08

常见问题

已经有短读长 WGS 数据了,还要不要补长读长?
看你的科学问题落在哪一层。SNP、InDel 这类小变异,短读长准确度高、成本低,没必要重做。结构变异、重复扩张、复杂重排、单倍型是长读长的主场:短读长在这些区域要么检不出,要么断点位置不准。常见做法是短读长做全队列的 SNP 分析,挑出关键家系或关键样本再补长读长定结构——案例二就是这条路径(先二代 WGS/WES 做连锁定位,再三代找重复扩张)。
测序深度要多少?
常规变异检测建议 30× 左右。如果主要目标是结构变异,可以参考案例一的实测结果:深度超过 15× 后 SV 数量增长就趋于饱和,也就是说 15–20× 已经能拿到大部分 SV,再加深度的边际收益递减。深度方案还要结合样本数量和预算一起定,建议把样本数和目标变异类型告诉技术顾问再算。
DNA 片段不够长会怎样?
直接的长读长能力打折。片段短了,跨重复区域和检 SV 的能力都会下降,数据看起来像"深度够但读长不够"的短读长升级版,优势出不来。送样规范把"5 kb 以下无小片段"列为核心指标就是这个原因。如果手上样本已经降解,建议重新取样;实在无法重取时,可以评估改用二代 WGS 或靶向方案,不要硬上长读长。
能做基因组组装吗?
能。长读长是从头组装(de novo)的主流方案,超长读长能跨过重复区域,把contig 连得更长。不过组装对数据量和覆盖度要求比"重测序 + 比对"更高,成本也更高。已有参考基因组的物种做重测序比对即可;非模式物种、或需要拿到完整基因组序列时才考虑组装,请提前说明物种、基因组大小和倍性。
甲基化是免费附带的吗?
同一批数据可以做,但不是"零成本"。纳米孔测的是原始 DNA 分子,甲基化信息天然留在信号里,不需要亚硫酸氢盐处理、也不用另外建库,所以不需要额外取样、不需要额外实验。但要拿到可靠的甲基化结果,需要配套的算法和参考对照,属于分析层面的额外工作,请在项目沟通时明确提出。
需要几个生物学重复?
群体遗传、病例-对照这类项目建议每组不少于 30 个样本才有统计效力;家系研究按家系结构设计。如果只是做单个个体的结构变异普查或基因组组装,1 个样本即可,但结论只描述该个体,不能外推到群体。
项目周期多久?
样本与 DNA 质检合格后,建库测序约 3-4 周,标准分析约 2 周;单倍型分型、群体选择分析、变异与表型关联等高级分析按需求另行约定;de novo 组装项目周期另计。
Get A Solution

获得技术方案

您有任何关于组学测序的项目问题,请留言给我们。技术团队将在工作日 24 小时内给您答复。

项目咨询

技术顾问对接具体课题,先讨论科学问题再谈检测清单

027-87050299

sales@rxbio.cc

寄样收样

李欣 13237124769
武汉市东湖高新区高新二路 388 号光谷生物医药加速器 18 栋 1-2 层

提交您的项目需求

填写以下信息,我们会尽快与您联系并给出技术方案建议。

提交即表示同意我们通过电话或邮件与您联系,仅用于项目沟通。