01
技术简介
肿瘤基因检测目前有几条常用路线:FISH、PCR、Sanger 测序和 NGS 。NGS 因为通量高、周期短、覆盖全面、成本可控,被广泛用于复杂疾病、遗传病筛查和肿瘤评估。基于高通量测序的肿瘤 Panel 检测,能定期监测变异、调整治疗方案,也为临床试验和跨适应症用药提供依据;NGS 大 panel 结合其他靶标,是肿瘤免疫治疗标志物检测的常用工具。
但这条路有两个绕不开的问题:基因覆盖不全 和测序深度不足 ,两者都会影响变异检测的准确性。而把 panel 做大来解决覆盖,成本又会明显上升——需要在全面性和预算之间反复权衡。
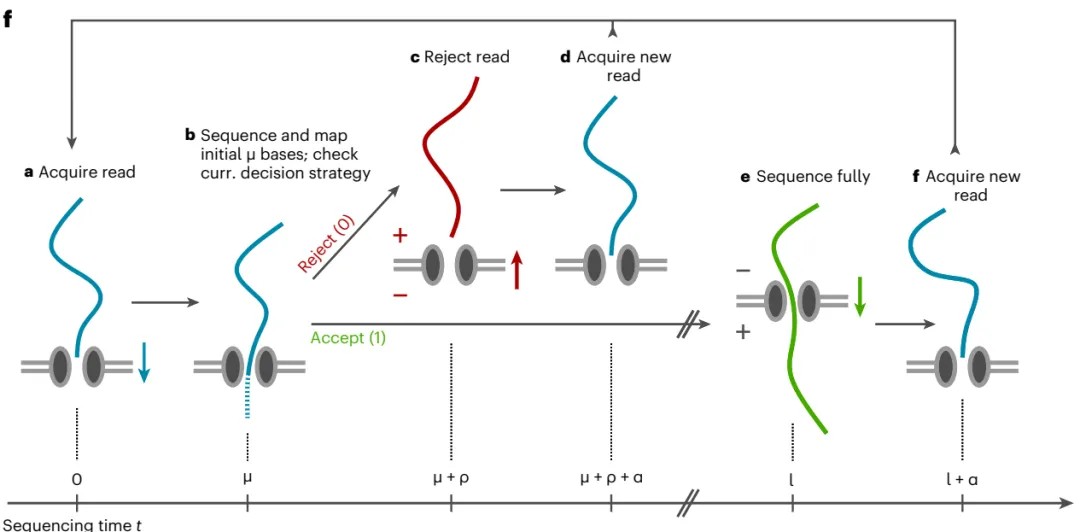
自适应测序 是纳米孔平台特有的功能,靠软件控制实现序列富集。运作方式是这样的:DNA 分子开始穿过纳米孔时,系统先检查它最初几百个碱基 的序列,与预先设定的靶向区域做精确比对。比对结果决定下一步:符合目标序列就让它完整通过、全面测序;不符合就调整纳米孔两端的电压,把这个分子弹出孔外 ,把孔位腾给下一个分子。
对研究者来说,最大的变化是前处理被省掉了 :不需要耗时的样品准备和富集工作,提取 DNA、接上接头就可以直接上机。
纳米孔自适应测序流程:先读几百个碱基做判断,留或弹由软件决定
02
技术优势
无需 PCR 扩增
减少了扩增偏差,同时保留碱基和修饰信息 。扩增环节一去掉,GC 偏好带来的覆盖不均、以及甲基化信息在扩增中被抹掉这两个问题都不存在了。
富集与耗尽两种模式
生信分析层面即可富集目标区域,无需复杂实验。富集模式 用于让目标区域多测;耗尽模式 反过来——把宿主或高丰度背景序列弹掉,用于微生物、混合样本这类场景。
快速建库
最快 10 分钟完成 ,适合临床快速应用。常规靶向捕获建库动辄一到两天,对需要快速出结果的场景(如术中、急重症)差别很大。
长读长跨越大片段区域
提升复杂结构变异检测能力。断点两端落在同一条 read 上,不像短读长那样只能靠覆盖深度突变或异常比对片段去推断。
实时数据分析
直接富集 DNA 目标序列,无需额外步骤。测序进行中就能看到目标区域的覆盖情况,够了就可以停,不用等整轮跑完。
经济高效
筛选已知和新的变异,适用于大型目标区域靶向测序。目标区域越大,相对探针捕获的成本优势越明显;换目标区域只需换 bed 文件,不用重新设计探针。
03
技术原理
整个判断发生在测序进行中 ,而不是实验台上。DNA 分子在马达牵引下进入纳米孔,仪器先读取它最初几百个碱基并做实时碱基识别,把这几百个碱基与 bed 文件里定义的靶向区域比对。
命中目标区域 → 放行
判定该分子符合用户的目标序列要求,立即启动全面测序流程,让整条分子完整通过纳米孔。
不在目标区域 → 弹出
判定不匹配,通过调整纳米孔两端的电压把该分子迅速弹出,为后续新的核酸分子腾出纳米孔空间。
因为判断用的是序列比对,所以换靶区不用换实验 :换一份 bed 文件就能改目标区域,同一份样本可以前后跑不同的基因组合,也可以先做一轮全基因组低深度、再对感兴趣区域做自适应采样。
还有一点常被忽略:被弹出的分子并非完全无用 。脱靶 reads 同样被测了几百个碱基,可以用来做 SNP 基因分型、多基因风险评分,也可以用来估计整体覆盖情况。案例二就用了这个思路。
04
实验流程
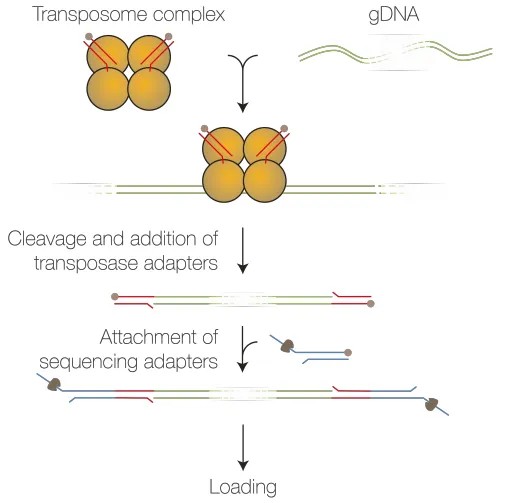
2 Tn5 片段化 用 Tn5 转座酶对 DNA 做片段化并带上接头序列
4 加载 bed 文件测序 ONT 测序仪选择针对特定检测基因的 bed 文件,运行自适应采样测序程序
ONT-TAS-seq 文库构建与测序流程
05
送样要求
自适应采样会主动丢弃一部分分子,因此 DNA 总量建议按 gDNA 测序列的门槛准备;如果同时要做甲基化检测,建议按 RRMS 的 ≥10 µg 准备 。
样本类型 ONT-TAS-seq 说明
DNA 总量 ≥5 µg (同时做甲基化检测建议 ≥10 µg)自适应采样会弹出一部分分子,起始量要留余量 DNA 纯度 OD260/280 1.7–1.9 ;OD260/230 2.0–2.2 230 比值偏低提示胍盐、酚或糖类残留 DNA 完整性核心 琼脂糖凝胶电泳 5 kb 以下无小片段 ;片段大小检测仪器(Qseq / Agilent 2100)在 5 kb 以下无明显峰 长片段比例直接决定 SV 检出能力 细胞 ≥1×10⁷ 个 由我方提取 gDNA 更稳妥 动物组织 · 心、脑、肾、肺 ≥50 mg 取新鲜组织,块尽量 ≤0.5 cm;去除结缔组织与脂肪;预冷 1×PBS 或生理盐水洗去血迹,液氮速冻后 −80 ℃ 保存,干冰运输,避免反复冻融 动物组织 · 肝、脾、胃 ≥20 mg 动物组织 · 皮肤、血管、软骨、骨等坚韧组织 ≥100 mg 植物组织 ≥500 mg 植物多糖多酚干扰提取,取样量需加大 全血 4 mL 按血液样本常规采血管要求采集与运输 免疫细胞 干体积 ≥20 µL 一般 10 µL 细胞干体积对应约 1×10⁶ 个细胞
临床样本要额外注意两点: ① FFPE 样本 DNA 片段化程度高,长读长优势会打折扣,请提前说明样本类型与保存年限,我们评估后再定方案;② 血液样本请按常规采血管要求采集,避免溶血——游离的基因组 DNA 会干扰目标区域的富集效率。
06
分析内容
标准分析 STANDARD
数据质控与富集效率统计reads 质控、目标区域富集倍数、目标区域覆盖深度与均一性
SNV / InDel 检测目标区域内的单核苷酸变异与小片段插入缺失
结构变异 SV 检测目标区域内的大片段缺失、插入、重复、倒位与易位
拷贝数变异 CNV基于覆盖深度的 CNV 检出
变异注释与解读数据库交叉注释、临床意义分级与候选变异排序
高级分析 ADVANCED
融合基因与重排解析融合伴侣识别、断点精确定位与重排模式刻画
单倍型与等位基因分析等位特异性变异、单倍型区块构建
甲基化与表观分析目标区域内的甲基化状态与等位基因特异性甲基化
脱靶 reads 二次利用用于 SNP 基因分型、多基因风险评分(PRS)计算
新变异的验证支持提供候选新变异清单与引物设计建议,供 Sanger 验证
07
应用案例
案例一
IF 11.6
Blood Cancer Journal · 儿童白血病
Genome profiling with targeted adaptive sampling long-read sequencing for pediatric leukemia
用靶向自适应采样长读长测序对儿童白血病做基因组分析
期刊: Blood Cancer Journal(IF 11.6) · 发表时间: 2024 年样本: 28 名白血病儿童(10 名急性髓性白血病、13 名 B 细胞急性淋巴细胞白血病、5 名 T 细胞 ALL)靶向区域: 466 个与血液恶性肿瘤相关的基因阅读原文: doi.org/10.1038/s41408-024-01108-5
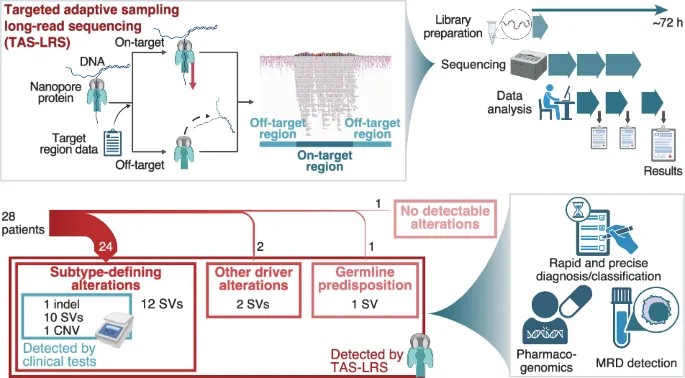
TAS-LRS 工作流程与儿童白血病基因组分型结果
研究发现: 纳米孔测序仪具备自适应采样功能,无需额外的靶向制备即可覆盖广泛的靶区域,在 SV 检测和单倍型变异识别上表现出色,且文库制备和测序时间短于传统方法。本研究共鉴定出 498 个 SNV、35 个小插入缺失和 632 个 SV ,其中部分被认为是驱动性改变。在 24 名患者中,TAS-LRS 确定了 85.7% 的基因组亚型 ,并且发现其中的新变异体全部是结构变异 。长读长结合靶向捕获测序能快速鉴定多类基因变体,包括融合基因 SV、隐性易位和复杂 SV;即使是低覆盖率的读取数据也能确定 CNV,检测范围大到整条染色体、小到几个基因。
案例二
IF 4.7
npj Genomic Medicine · 遗传性癌症
Assessing the efficacy of target adaptive sampling long-read sequencing through hereditary cancer patient genomes
通过遗传性癌症患者基因组评估靶向自适应采样长读长测序的效能
期刊: npj Genomic Medicine(IF 4.7) · 发表时间: 2024 年样本: 33 例疑似遗传癌综合征患者 · 靶向区域: 147 个癌症易感基因阅读原文: doi.org/10.1038/s41525-024-00394-z
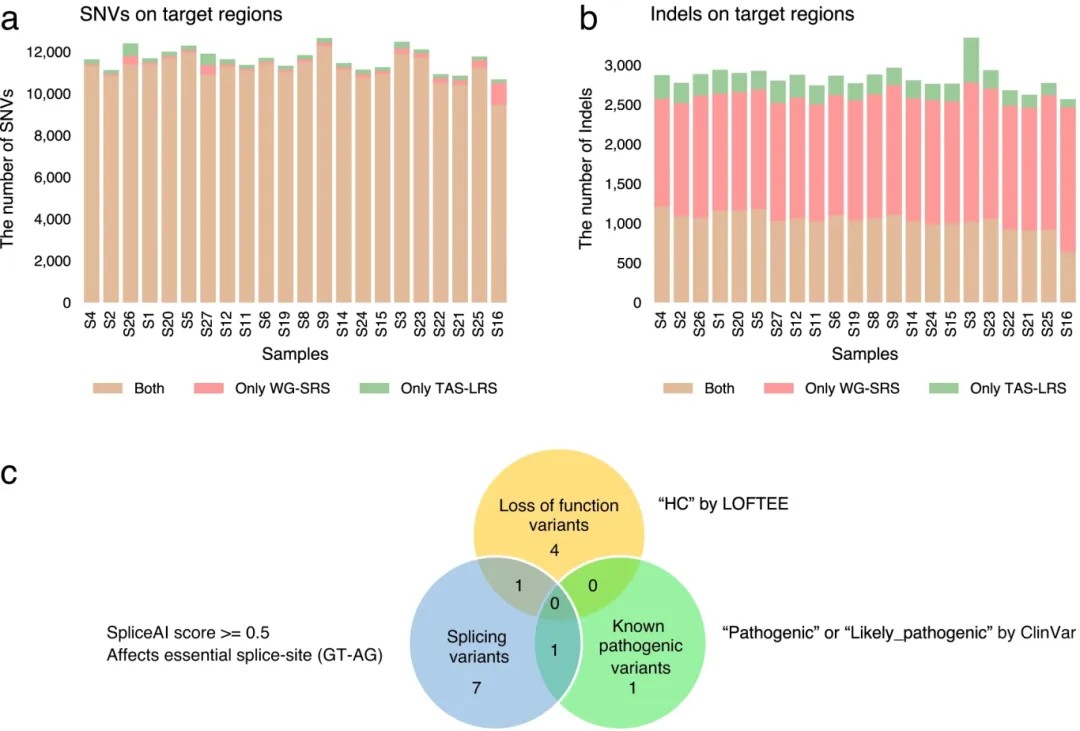
TAS-LRS 工作流程:同时捕获单基因、多基因风险变异与表观遗传改变
研究发现: 作者开发了 TAS-LRS 计算工作流程,用于疑似遗传性癌症患者的基因组评估,既识别单核苷酸变异,也阐明结构变异的具体形式。新鉴定了家族性腺瘤性息肉病患者的 SVA 元件及其起源位点 。研究还证明,自适应采样的脱靶读数可以用于 SNP 基因分型、计算多基因风险评分 ——被弹出的那部分数据并非废料。在一例林奇综合征患者中还发现了等位基因特异性的 MLH1 启动子高甲基化 。综合来看,TAS-LRS 工作流程能同时捕获单基因变异、多基因风险变异及表观遗传改变,可作为遗传病研究和诊断的有效平台。
案例三
IF 16.6
Cancer Research · 癌症易感性
Nanopore adaptive sampling detects nucleotide variants and improves large scale rearrangement characterization for diagnosis of cancer predisposition
纳米孔自适应采样检测核苷酸变异并改善大规模重排特征,用于癌症易感性诊断
期刊: Cancer Research(IF 16.6) · 发表时间: 2024 年(AACR 年会摘要)样本: 30 份临床种系样本,携带已知 BRCA1、BRCA2、PALB2 和 MLH1 基因改变 · 靶向区域: 152 个癌症易感基因阅读原文: doi.org/10.1158/1538-7445.AM2024-2936
研究发现: 队列中有 11 个样本存在大规模重组(LSR) ,由 ONT 测序检出。除检出 LSR 位点外,还发现 BRCA1 基因中外显子 13 的 MLPA 扩增实为外显子 12 和 13 的扩增 ,并在患者亲属中得到证实——这类"常规方法判错、长读长纠正"的案例,正是长读长在临床遗传诊断里的价值所在。另一例 LSR 为 BRCA1 基因完全缺失 ,由近 140 kbp 的大片段缺失导致,该缺失同时包含 5 种基因。ONT 测序在低覆盖率样本中也能检测到 5 类 SNV ;生物信息学检测确认了均聚物区域的 3 个突变。分析完整基因时还发现了新的未知变异,通过 Sanger 测序验证的 8 个新变异全部得到证实 ,说明 ONT 检测变异的结果可靠。综合来看,ONT 自适应采样测序适用于种系改变分析,能改善 LSR 的分辨率,并在低覆盖率下检出 SNV。
08
常见问题
自适应采样和探针杂交捕获有什么本质区别? 区别在于富集发生在哪个环节 。探针捕获在实验台上做:合成或购买探针、与样本杂交、洗去未结合、再扩增,一整套流程一到两天,且目标区域固定、换一次就要重买探针。自适应采样在测序过程中 由软件完成:提取 DNA、接上接头、加载 bed 文件即可上机,建库最快 10 分钟,换目标区域只需换 bed 文件。另外自适应采样不做 PCR,扩增偏差和 GC 偏好都没有,甲基化信息也保留下来。
富集模式和耗尽模式分别用在什么场景? 富集模式 用于"我要多测这些区域":肿瘤 panel、易感基因、特定染色体区段都是典型场景。耗尽模式 反过来,用于"我不想看到这些序列":宿主基因组占比过高时把宿主弹掉、让微生物或病原体序列测得更深;混合样本里剔除高丰度背景也是同一思路。两种模式可以在同一轮实验里组合使用。
目标区域能有多大? 可以很大。因为富集不依赖探针数量,目标区域扩大不会带来探针成本线性上升,所以在大 panel、全外显子级别甚至整条染色体 的尺度上,自适应采样相对探针捕获更有成本优势。不过目标区域越大,富集倍数越低——等效深度还是受总通量约束。实际方案要按区域大小、所需深度和样本数量一起核算。
富集倍数大概能到多少? 取决于目标区域大小、片段长度分布和 bed 文件设计。目标区域小(几十个基因)时富集倍数很高;几百个基因仍能有明显富集。要注意的是,长片段的富集效率依赖 DNA 完整性 ——片段太短,一条 read 测完也进不了几个目标位点,富集效果会打折,这也是送样规范强调 5 kb 以下无小片段的原因。
FFPE 样本能做吗? 能做,但要降低预期。FFPE 样本的 DNA 片段化程度高,长读长在结构变异上的优势会明显打折;SNV 和小 InDel 的检测影响相对小。如果课题核心是 SV 或融合基因,优先用新鲜冰冻组织或外周血;只有 FFPE 可用时,请提前说明样本类型、固定方式和保存年限,我们评估后再定方案。
和 ONT-RRMS 是什么关系? 两者用的是同一个底层能力——自适应采样,差别在目标区域和分析侧重 。RRMS 是固定针对富 CpG 区域的方案(人 310 Mb / 小鼠 308 Mb),重点做甲基化,附带出 CNV、SV、SNP。TAS-seq 是通用靶向方案,目标区域由课题决定,重点做变异检测,甲基化作为附加项。如果你要的就是甲基化,直接选 RRMS;如果是自定义基因 panel,选 TAS-seq。
项目周期多久? 样本与 DNA 质检合格后,快速建库与测序约 2–3 周,标准分析约 2 周。融合基因解析、单倍型分析、多基因风险评分等高级分析按需求另行约定。