01
技术简介
真核生物基因表达受 RNA 聚合酶、转录因子、组蛋白修饰等调控。表观遗传研究者提出染色质免疫沉淀技术(ChIP)以定位 DNA-蛋白质互作区域;随着二代测序技术发展,ChIP 与测序结合开发出 ChIP-seq 技术。以单碱基分辨率匹配转录因子结合足迹,对研究转录因子结合调控机制至关重要。
但传统 ChIP-seq 技术分辨率有限,无法确定具体结合位点。为确定具体结合位点,需预测结合位点并进行单碱基突变,构建大量报告基因载体进行验证——这些方法工作量大、周期长、假阳性高。
美国宾州州立大学帕克分校 Frank Pugh 教授团队开发了 ChIP-exo 技术,以单核苷酸分辨率定位全基因组转录因子结合位点。不过 ChIP-exo 相比 ChIP-seq 需要 DNA 末端修复、加 A、连接接头等步骤,降低了 DNA 回收量;DNA 片段需经历 2 次低效连接以获得两端接头,低起始量 ChIP DNA 在文库制备 PCR 中易过度扩增,导致不可重复的噪音数据。
瑞兴生物经过自主开发和优化,利用 λ-核酸外切酶消化 DNA 会产生单链 DNA(ssDNA) 的特点,对单链 DNA 作为模板进行文库构建,省去 λ-核酸外切酶消化之前需要对 DNA 进行末端修复、加 A、连接接头等反应和漂洗等操作步骤,提高可被回收的 DNA 量,提高文库构建成功率和产量。
02
技术优势
高分辨率
达到单碱基分辨率,直接看到转录因子在 DNA 上的精确落脚点,不必再用报告基因突变逐个验证。
特异性强
核酸外切酶消化降低背景 DNA——只有被蛋白保护起来的片段才能留下,未结合区域被逐步降解。
高信噪比
消除检测系统产生的大量噪音,峰形更锐利、边界更清晰,重复样本之间的一致性明显提升。
流程简单、成功率高
以单链 DNA 为模板建库,省去末端修复、加 A 与接头连接等反应和漂洗,减少两步低效连接带来的 DNA 损失,提高文库构建成功率和产量。
03
技术原理
ChIP-exo 的核心是用外切酶的"消化边界"来定义蛋白足迹。甲醛交联把蛋白-DNA 相互作用固定,超声打断染色质,免疫沉淀把目标蛋白连同它保护的 DNA 片段一起拉下来。
随后 λ-核酸外切酶从 5′ 端开始消化 DNA,一直啃到被蛋白挡住的位置才停下——酶切终止点就是蛋白在 DNA 上的结合边界。对这些边界一致的 DNA 建库测序,reads 的 5′ 端在基因组上会聚集成清晰的峰,峰的边界精确到单个碱基。
瑞兴生物的改进在于建库路线:外切酶消化会产生单链 DNA(ssDNA),直接以 ssDNA 为模板建库,就不必在消化前先做末端修复、加 A 和接头连接——少两步反应和漂洗,DNA 回收量更高,文库成功率与产量随之提高。
04
实验流程
1甲醛交联
固定蛋白-DNA 相互作用,保留体内结合状态
3免疫沉淀
靶蛋白抗体捕获蛋白及其保护的 DNA 片段
4核酸外切酶消化
λ-核酸外切酶从 5′ 端消化至蛋白边界停止
5提取 DNA
回收被蛋白保护的 DNA 片段(含 ssDNA)
6单链 DNA 建库
以 ssDNA 为模板建库,免末端修复与接头连接
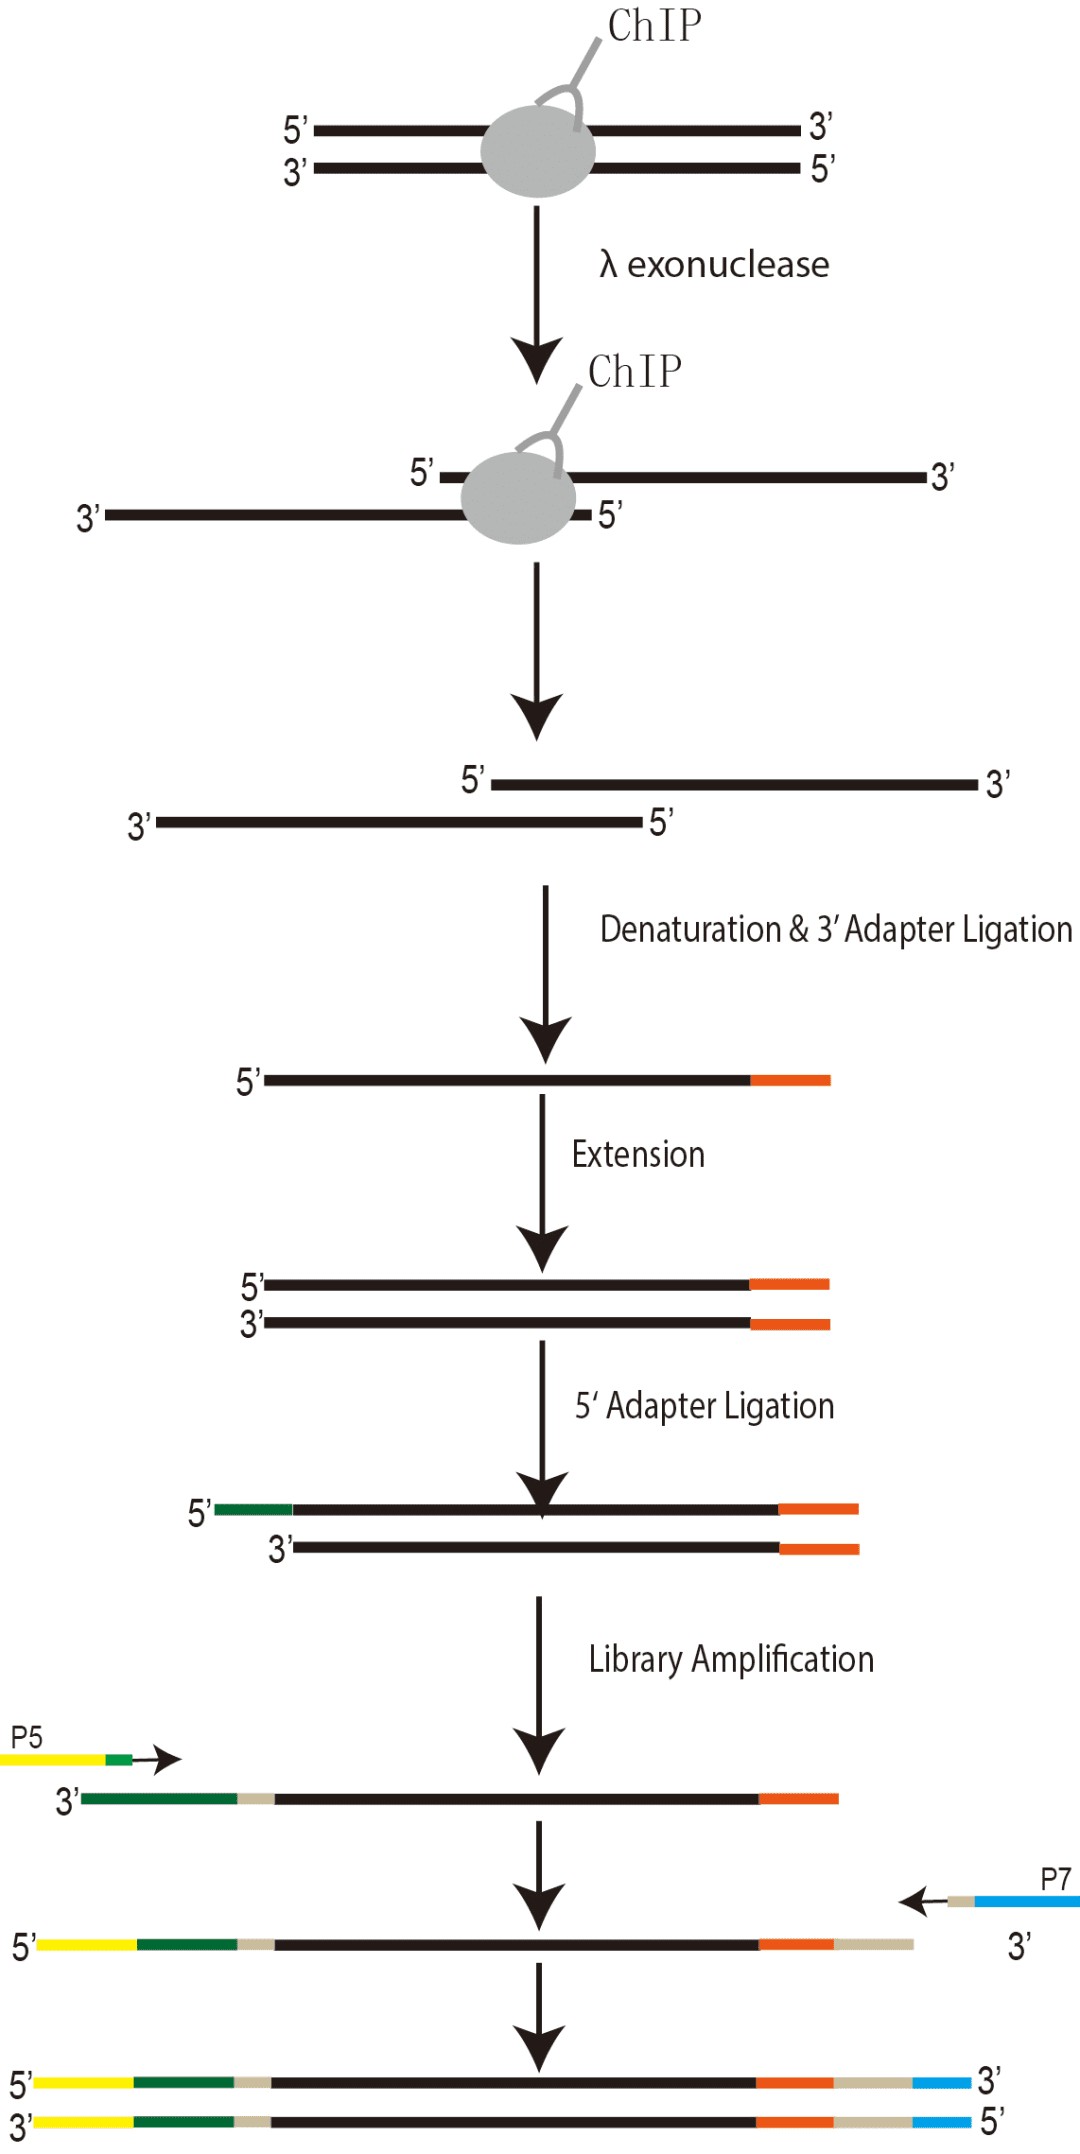 ChIP-exo 实验流程:交联 → 打断 → IP → 外切酶消化 → 提取 → ssDNA 建库
05
样本要求
ChIP 级抗体是项目启动的前提,请随样本一并提供抗体信息。
| 样本类型 | 要求 | 说明 |
|---|
| 抗体 | ChIP 级 ≥40 µg 或按说明书(一般 ≥40 µL) | 需能识别交联后靶蛋白;建议提供 ChIP / IF 数据佐证 |
| IP 后 DNA | ≥5 ng(Qubit 定量) | 若实验室已完成 IP,可直接提供 IP 后 DNA 建库 |
| 细胞 | ≥8×10⁷ 个 | 活细胞状态良好、无污染;组织取目标区域,避免坏死与钙化部分 |
| 细胞干体积 | ≥80 µL |
| 动物组织 · 心、脑、肾、肺 | ≥300 mg | 新鲜组织液氮速冻后 −80 ℃ 保存,干冰运输;避免反复冻融 |
| 动物组织 · 肝、脾、胃 | ≥300 mg |
| 动物组织 · 皮肤、血管、软骨、骨等坚韧组织 | ≥500 mg |
| 植物组织 | ≥1 g | 选健康幼嫩组织;70% 酒精冲洗表面后液氮速冻,干冰运输 |
06
分析内容
标准分析 STANDARD
原始数据处理fastqc 质控、trimmomatic 去接头与低质量碱基、MultiQC 汇总;Clean 数据统计含 Q20 / Q30 / Dup / GC
比对统计Bowtie2 比对到参考基因组,统计 total / unique / multiple mapped 比例
信号分布reads 在 TSS 上下游 3kb、基因本体上下游 3kb 的密度分布热图
样本关系PCA 主成分分析 + Pearson 相关性热图,判断重复一致性与离群样本
双软件 Peak callingGeneTrack 平滑寻峰 + ChExMix 建模识别结合事件;bedtools subtract 扣除对照,保留实验组特异峰
Peak 注释与组内重叠ChIPseeker 注释功能区域与距 TSS 距离;DiffBind 合并修剪后做组内重叠 Venn
峰相关基因富集仅取注释到启动子(TSS ±3kb)的峰基因,做 GO 与 KEGG 通路富集
Motif 富集HOMER 分析样本特异峰;含 GeneTrack 与 ChExMix 交集峰的基序比较
高级分析 ADVANCED
组间差异结合分组比较结合强度,找处理前后差异位点
与 RNA-seq 联合结合位点 × 表达量变化,区分直接与间接调控
多因子共占位多个因子结合位点叠加,解析协同与互斥
核小体定位由 reads 分布推断核小体位置与占据状态
多组学整合与 ATAC-seq、甲基化数据联合解析调控网络
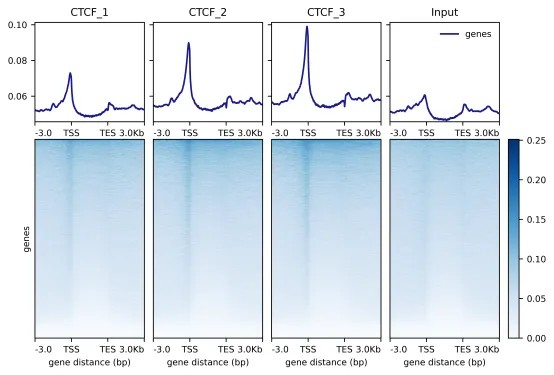 实测数据:H3K4me3 / CTCF reads 在基因组上的分布
07
应用案例
案例一
IF 48.5
Nature · 酵母基因组蛋白架构
A high-resolution protein architecture of the budding yeast genome
芽殖酵母基因组的高分辨率蛋白架构
期刊:Nature(IF 48.5,2024 JCR) · 发表时间:2021 年
阅读原文:doi.org/10.1038/s41586-021-03314-8
样本与方法:酿酒酵母;作者采用 ChIP-exo / seq 技术,共完成 1,200 多个 ChIP-exo 实验,生成数十亿数据点,并借助宾州州立大学的超级计算集群和自创的生物信息学工具进行分析。
- 画出酵母全基因组蛋白结合图谱:识别并揭示了酵母基因组中调节蛋白的组织模式,共定义 21 个元组合、包含约 400 种不同蛋白质,与 DNA 复制、着丝粒、亚着丝粒、转座子及 RNA 聚合酶(Pol)I、II、III 的转录相关。
- 染色质结构的系统图景:复制蛋白吞噬核小体,着丝粒无核小体,抑制性蛋白在亚端粒 X 元件处有 3 个核小体。Pol II 相关启动子大多缺乏调控区、仅含核心启动子,这些启动子含与 +1 核小体相邻的短无核小体区(NFR),与转录起始因子 TFIID 结合形成预起始复合物。
- 发现两种基因调控结构:组成型基因执行基础功能、需简单调节;诱导型基因对环境信号敏感、结构更复杂。该发现扩展了传统调控模型——传统模型认为转录因子结合 DNA 控制表达,但酵母中大多数"管家"基因缺乏特定蛋白质 DNA 结构,这是可诱导基因的特点。
研究还表明,酵母基因组中少数独特蛋白质组合被重复使用,为理解真核生物基因调控的模块化组织提供了高分辨率基础。
08
常见问题
ChIP-exo 和 ChIP-seq 怎么选?
ChIP-seq 给出的是区间级结合信息(峰宽数百 bp),适合大多数表达调控研究;ChIP-exo 给出的是单碱基级结合足迹,适合需要精确定位结合位点、区分密切相关的蛋白复合物成员、或研究核小体位置的课题。若问题出在"具体结合在哪个碱基",选 ChIP-exo;若只关心"结合在哪个基因附近",ChIP-seq 性价比更高。
ChIP-exo 对起始量要求高吗?
相对较高。传统 ChIP-exo 需要末端修复、加 A 和两次低效接头连接,DNA 损失大,低起始量样本容易在 PCR 阶段过度扩增、产生不可重复的噪音。瑞兴生物改用单链 DNA 建库路线后省去这些步骤,DNA 回收量明显提高。按送样规范,细胞 ≥8×10⁷、组织 ≥300 mg。
抗体有什么特殊要求?
需要 ChIP 级抗体 ≥40 µg(或按说明书),且必须能识别甲醛交联后的靶蛋白——很多抗体在 WB 上好用,但交联后表位被遮蔽就用不了。建议提供抗体说明书或已有 ChIP / ChIP-seq 数据,由我方评估后再下单。
可以研究组蛋白修饰吗?
可以。除转录因子外,组蛋白修饰(如 H3K4me3、H3K27ac)同样适用,实测数据中就包含 H3K4me3 的 reads 基因组分布与 Peak 功能区域分布。组蛋白抗体通常更稳定,项目成功率高于部分转录因子抗体。
项目周期多久?
CHIP-exo 为 6–9 周,抗体购买一般额外 1–2 周。
和 CUT&Tag 是什么关系?
两者都追求高信噪比的蛋白-DNA 互作图谱,思路不同:ChIP-exo 靠免疫沉淀 + 外切酶消化提高分辨率;CUT&Tag 用 Protein A-Tn5 融合蛋白在抗体指引下直接切割并加接头,起始量更低(可到单细胞水平)、操作更快。需要单碱基足迹与已有 ChIP 级抗体时选 ChIP-exo,样本量极少或想做单细胞时选 CUT&Tag。
