
MeRIP-seq m6A 甲基化测序
m6A 是真核转录组里最丰富的 RNA 修饰:超过 7,000 个 mRNA 和 300 个 lncRNA 带有它,且富集在终止密码子附近和 3′UTR——正是调控最密集的区域。MeRIP-seq 用 m6A 特异性抗体把修饰片段抓出来测序,在全基因组范围回答"哪些 RNA 在哪些位点被甲基化"。
技术简介
m6A 修饰在人转录组 RNA 中广泛存在。目前研究表明:超过 7,000 个 mRNA 和 300 个 lncRNA 都含有这种修饰;这种修饰富集分布在 mRNA 的终止密码子附近和 3′UTR 区域,暗示 m6A 修饰具有重要的调控功能。
很多 m6A 修饰位点在人和小鼠中保守存在,且某些 m6A 修饰在不同发育时期其修饰水平也在不断变化,同样暗示其重要的调控功能。
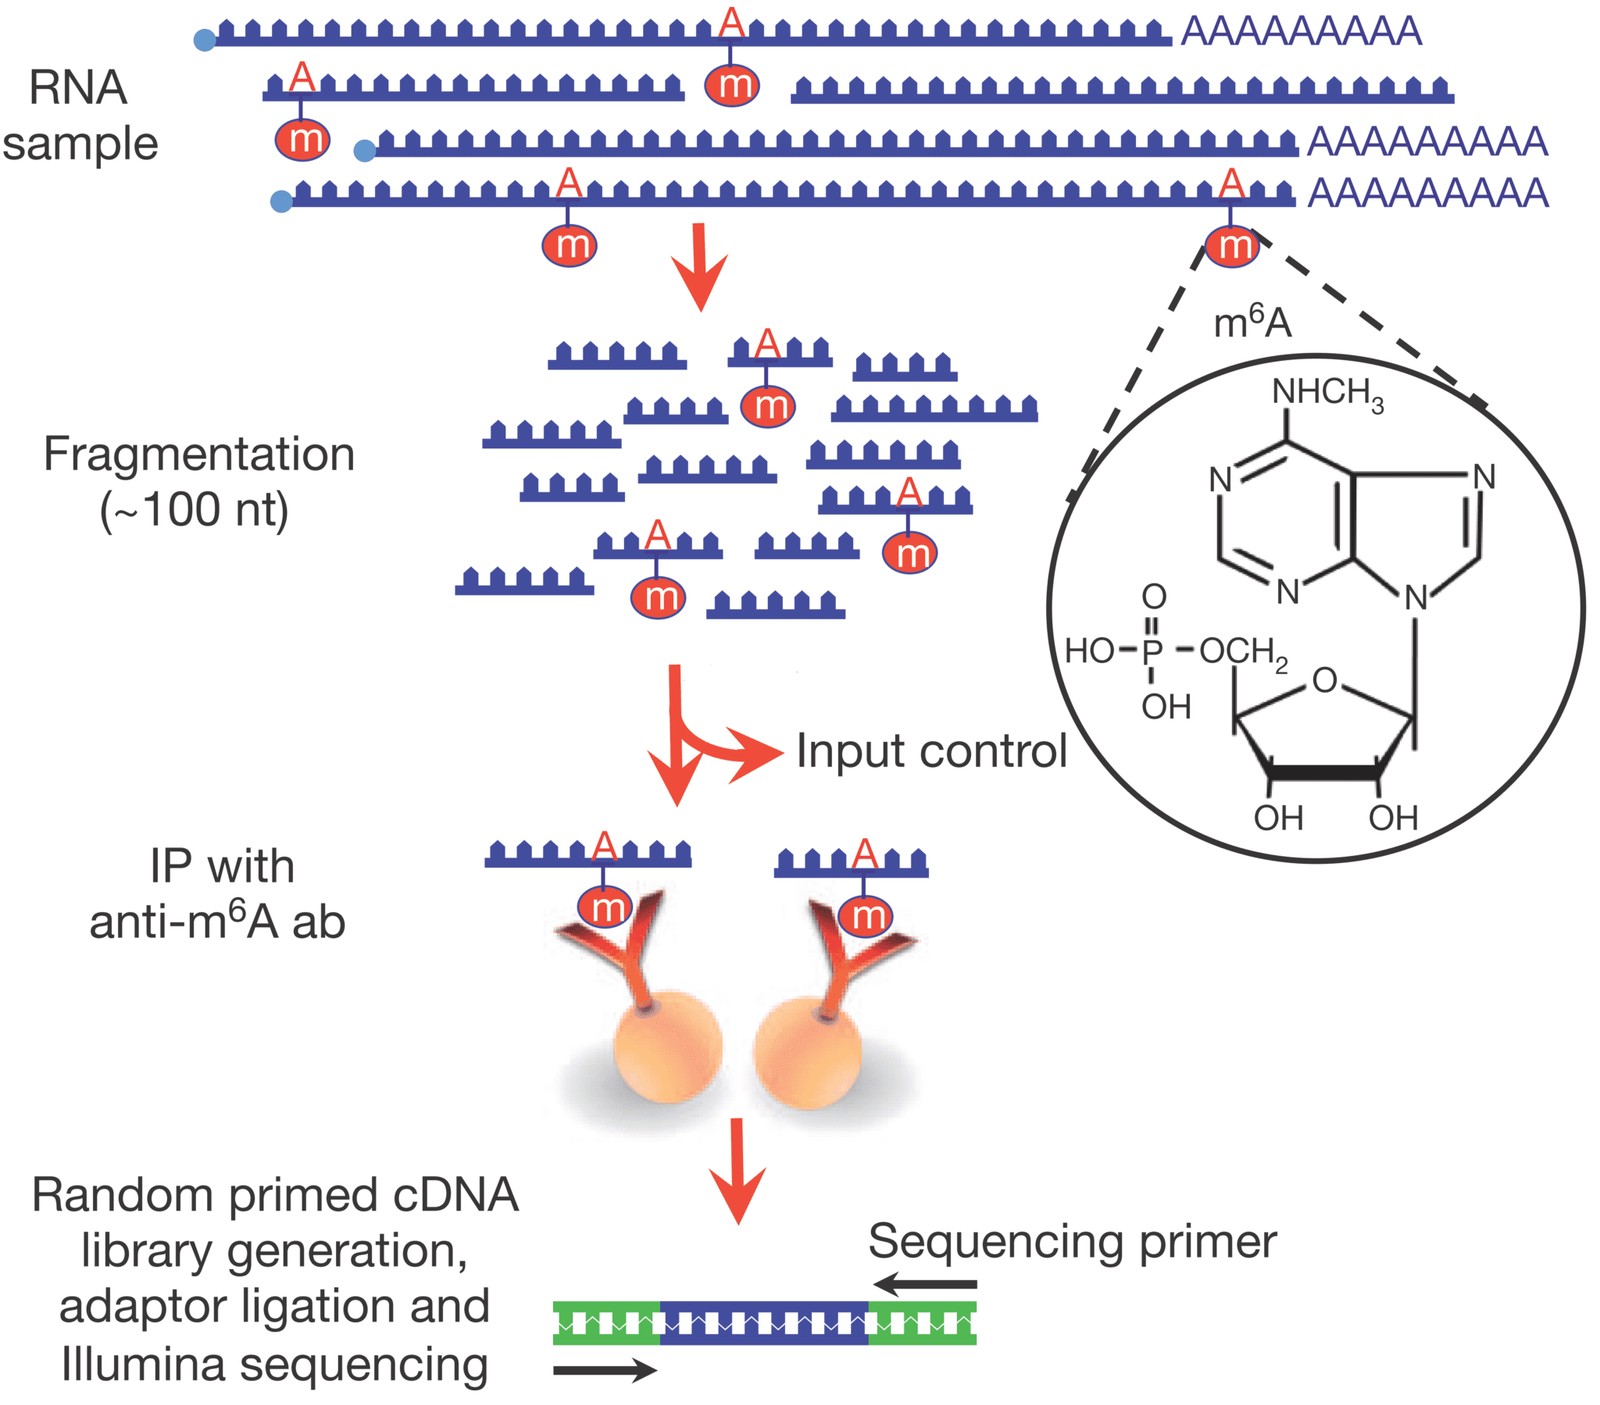
目前对 m6A 的全基因组研究方法为 meRIP-seq(也称 m6A-seq)。其原理为:通过特异识别 m6A 修饰的抗体,对细胞内具有 m6A 修饰的 RNA 片段进行免疫共沉淀;通过对沉淀下来的 RNA 片段进行高通量测序,进而结合生物信息学分析,即可在全基因组范围内对 m6A 修饰的状况进行系统研究。
技术优势
个性化研究方案
针对不同研究领域提供个性化方案,按物种、样本类型与研究目标调整实验与分析设计。
分析流程全备
分析流程全备,数据解读详细,后期数据挖掘可提供个性化分析,不只交一份 peak 列表。
双策略峰分析
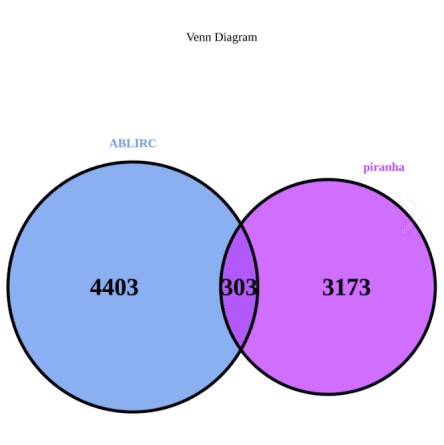
结合峰分析策略多种:含 ABLIRC 和 Piranha 两种方法,两套算法互相印证,提高峰检出的稳健性。
研究思路丰富
m6A 修饰图谱及修饰特征分析,不同实验分组间差异 m6A 修饰位点和基因鉴定;与 RNA-seq、CLIP-seq 数据等联合分析,揭示 m6A 修饰的功能。
技术流程
RNA 提取与片段化
提取总 RNA,片段化至适合免疫沉淀长度
m6A 免疫沉淀
m6A 特异性抗体富集修饰 RNA 片段
Input 对照制备
同步制备 Input 对照,用于背景评估
文库构建与测序
IP 与 Input 分别建库,高通量测序
峰调用
ABLIRC 与 Piranha 双策略识别 m6A 峰
联合分析
与 RNA-seq、CLIP-seq 数据整合解析功能
样本要求
m6A 抗体由我司提供,客户无需自备抗体,这是本项目相对其他 IP 类实验最省心的一点。
| 样本类型 | 送样量 | 说明 |
|---|---|---|
| Total RNA(自行提取) | ≥5 µg 且浓度 ≥200 ng/µL | A260/A280 1.8–2.2、RIN ≥7;干冰运输 |
| IP 后 RNA | ≥10 ng(Qubit 定量) | 若实验室已完成 m6A IP,可直接提供 IP 后 RNA 建库 |
| 细胞 | ≥2×10⁷ 个 | 活细胞状态良好、无污染;组织取目标区域,避免坏死与钙化部分 |
| 细胞干体积 | ≥20 µL | |
| 动物组织 · 心、脑、肾、肺 | ≥250 mg | 新鲜组织液氮速冻后 −80 ℃ 保存,干冰运输;避免反复冻融 |
| 动物组织 · 肝、脾、胃 | ≥200 mg | |
| 动物组织 · 皮肤、血管、软骨、骨等坚韧组织 | ≥500 mg | |
| 植物组织 | ≥1 g | 选健康幼嫩组织;70% 酒精冲洗表面后液氮速冻,干冰运输 |
分析内容
标准分析 STANDARD
- 数据质控与文库评估MultiQC 汇总;碱基质量、GC 含量、有效长度、cDNA 文库 PCR 重复率
- 比对与去冗余unique / multiple、splice / nonsplice、sense / antisense 分类统计,rmdup 后进入后续分析
- 基因组分布与覆盖度5′UTR / 3′UTR / CDS / 非编码外显子 / 内含子 / 基因间区占比;转录单元与基因体各切 100 bin 的覆盖曲线
- TSS / TTS 与样本关系reads 在 TSS、TTS、起始与终止密码子附近的分布;样本相关性热图与聚类
- m6A 峰识别与统计ABLIRC(500 次随机模拟定背景)与 Piranha(ZTNB 模型)双策略,以 Input 为背景;输出峰数、峰内 reads 数、关联基因数
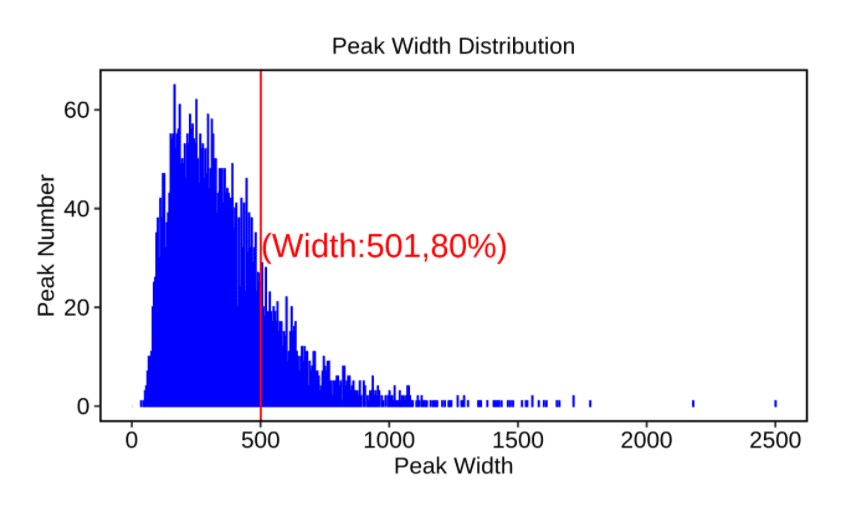
- 峰宽度、峰分布与重叠分析峰长度直方图与基因组功能区域注释;两次重复间的峰重叠 Venn,再取 ABLIRC 与 Piranha 的交集
- Motif 富集峰内序列基序富集,确认 DRACH 类 m6A 特征
- 峰相关基因富集GO 三类(BP / CC / MF)与 KEGG 通路,取显著条目展示
高级分析 ADVANCED
- 组间差异 m6A分组比较修饰水平,鉴定差异修饰位点与基因
- 与 RNA-seq 联合修饰丰度 × 表达变化,区分修饰与转录的先后关系
- m6A 与剪接 / 稳定性关联修饰位点落在 3′UTR 或剪接 junction 附近时的功能指向
- 与 RBP 结合谱联合叠 m6A reader / writer 的 CLIP 数据,解析识别与功能分工
- 修饰位点保守性跨物种比对看 m6A 位点的序列与位置保守性
实测数据
下面两张图来自我司 MeRIP-seq 项目的真实测序结果,对应峰识别环节的两个关键质控点:峰宽度是否合理,以及两套峰调用算法的结果是否相互印证。
应用案例
Attenuated Duck Hepatitis A Virus Infection Is Associated With High mRNA Maintenance in Duck Liver
鸭甲型肝炎病毒感染通过 m6A 修饰与鸭肝中高 mRNA 维持相关
期刊:Frontiers in Immunology(IF 5.9,2024 JCR) · 发表时间:2022 年(Vol 13, Article 839677) · 团队:四川农业大学动物医学院
数据存档:GEO: GSE163905 · 阅读原文:doi.org/10.3389/fimmu.2022.839677
样本与方法:强毒性和弱毒性的鸭甲型肝炎病毒(DHAV)感染的雏鸭肝脏组织,感染后 12 / 24 / 36 / 48 hpi 取样;m6A-seq(MeRIP-seq)测序 + RNA-seq 整合分析,并用 m6A 抗体 dot blot 与 LC–MS/MS 对全局修饰水平做独立定量。
瑞兴支持:本项目由我司团队提供 m6A-seq 测序与数据分析支持——poly(A)+ mRNA 富集与 m6A 抗体免疫沉淀、建库测序、峰调用(ABLIRC 流程)、差异修饰基因鉴定(edgeR)以及 m6A-seq × RNA-seq 整合分析,产出该课题的核心数据(论文署名单位:ABLife BioBigData Institute, Wuhan / Center for Genome Analysis, ABLife, Inc., Wuhan)。该项目各环节的实测数据见上一节「项目实测数据」。
研究发现:研究首次分析了鸭子 mRNA 上的 m6A 修饰水平及分布特征,发现 GAAGAAG 是修饰基序最丰富的基序。整合分析 m6A-seq 和 RNA-seq 数据,发现 m6A 与 DHAV 感染雏鸭肝脏中 mRNA 表达水平总体呈正相关(Wu et al. 2022)——这一结果与哺乳动物系统中常见的"m6A 促进降解"形成对照,提示修饰功能可能具有物种与情境特异性。
该研究展示了 MeRIP-seq 在非模式动物(禽类)中的适用性,也说明"先看修饰图谱、再看修饰与表达的关联"是 m6A 功能研究的标准切入路径。
常见问题
MeRIP-seq 能给出单碱基分辨率的 m6A 位点吗?
为什么用两种峰分析策略?
需要准备抗体吗?
m6A 和 RNA 表达的关系一定是负相关吗?
需要多少生物学重复?
项目周期多久?
获得技术方案
您有任何关于组学测序的项目问题,请留言给我们。技术团队将在工作日 24 小时内给您答复。
寄样收样
李欣 13237124769
武汉市东湖高新区高新二路 388 号光谷生物医药加速器 18 栋 1-2 层
提交您的项目需求
填写以下信息,我们会尽快与您联系并给出技术方案建议。